Category Archives: Stata

Cách viết chương 4 luận văn dữ liệu bảng bằng Stata: từ FE, RE đến FGLS

Với luận văn dùng dữ liệu bảng, chương 4 không chỉ là đọc một bảng hồi quy. Hội đồng muốn thấy chuỗi lập luận chọn mô hình: vì sao chọn FE thay vì RE, mô hình có khuyết tật gì, và bạn khắc phục ra sao. Bài này hướng dẫn viết chương 4 theo đúng thứ tự đó, kèm lệnh Stata, cách xuất bảng và mẫu câu diễn giải.

Quy trình 8 bước của chương 4 (dữ liệu bảng)

  1. Thống kê mô tả và ma trận tương quan
  2. Chạy mô hình Pooled OLS, Fixed Effects (FE), Random Effects (RE)
  3. Lựa chọn mô hình: kiểm định F, Breusch-Pagan LM, Hausman
  4. Kiểm tra đa cộng tuyến
  5. Kiểm tra phương sai sai số thay đổi
  6. Kiểm tra tự tương quan
  7. Khắc phục bằng FGLS (hoặc sai số chuẩn vững)
  8. Bảng kết quả cuối cùng, diễn giải và thảo luận

Trong bài, ví dụ dùng biến phụ thuộc roa, các biến độc lập size, lev, growth, biến định danh doanh nghiệp id và biến thời gian year. Bạn thay bằng biến của mình.

Bước 1. Thống kê mô tả và ma trận tương quan

Khai báo dữ liệu bảng trước khi làm bất cứ thứ gì:

xtset id year

. xtset id year

Panel variable: id (strongly balanced)
 Time variable: year, 2015 to 2024
         Delta: 1 unit

Xuất bảng thống kê mô tả:

ssc install estout, replace

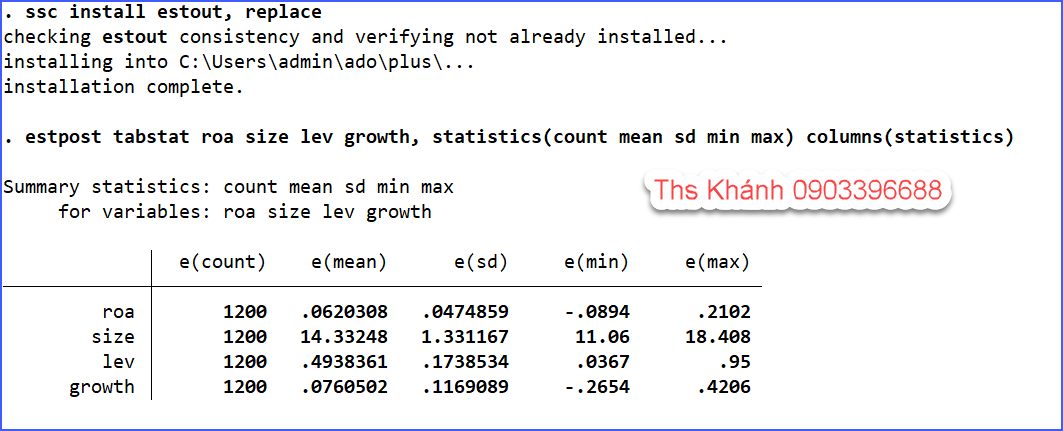
estpost tabstat roa size lev growth, statistics(count mean sd min max) columns(statistics)

esttab using thongke.rtf, cells("count mean(fmt(3)) sd(fmt(3)) min(fmt(3)) max(fmt(3))") noobs nomtitle nonumber replace
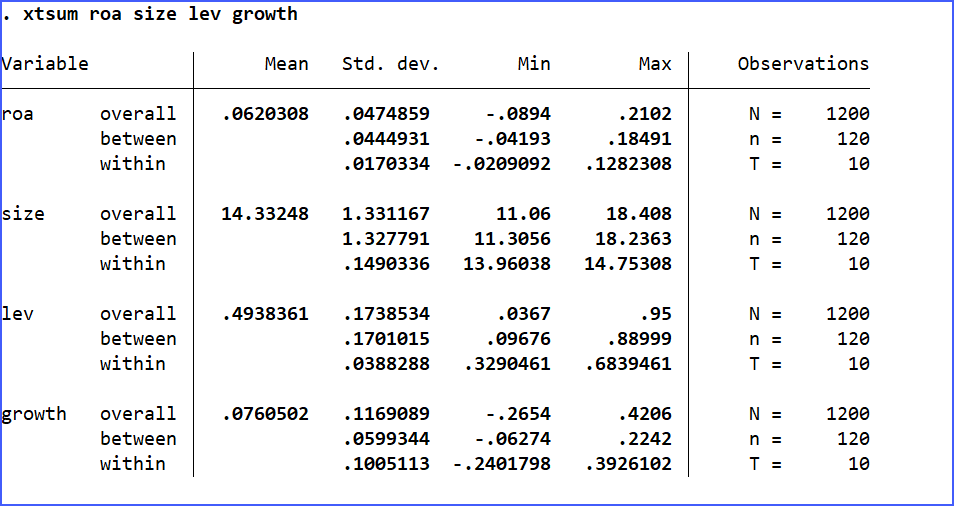
Với dữ liệu bảng, có thể dùng thêm lệnh xtsum để tách độ biến thiên giữa các đơn vị (between) và theo thời gian (within):

xtsum roa size lev growth
Ma trận tương quan:

pwcorr roa size lev growth, star(0.05) sig

Cách diễn giải: nêu giá trị trung bình, độ phân tán, giá trị min/max bất thường, số quan sát và số đơn vị (N, T). Với tương quan, chỉ ra chiều và độ mạnh sơ bộ, nhắc rằng tương quan chưa phải nhân quả.

Mẫu câu: "Bảng 4.1 cho thấy mẫu gồm 1.200 quan sát của 120 doanh nghiệp trong giai đoạn 2015–2024. ROA có giá trị trung bình 0,062, độ lệch chuẩn 0,048, giá trị nhỏ nhất -0,15 và lớn nhất 0,31, cho thấy hiệu quả hoạt động chênh lệch đáng kể giữa các doanh nghiệp."

Nếu gặp lỗi unbalanced khi xtset, xem bài Dữ liệu bảng bị lỗi unbalanced panel khi dùng lệnh xtset.

Bước 2. Chạy mô hình Pooled OLS, FE và RE

Chạy ba mô hình và lưu kết quả để so sánh:

regress roa size lev growth

estimates store pooled

xtreg roa size lev growth, fe

estimates store fe

xtreg roa size lev growth, re

estimates store re

Ở bước này chưa vội diễn giải hệ số. Việc cần làm là cho hội đồng thấy bạn đã ước lượng cả ba mô hình và sẽ chọn mô hình phù hợp ở bước 3. Xem thêm bài Mô hình tác động cố định Fixed effects và các kiểm định liên quan và Mô hình tác động ngẫu nhiên Random Effects và cách chạy trong Stata.

Bước 3. Lựa chọn mô hình: F test, Breusch-Pagan LM, Hausman

Quy trình chọn mô hình gồm ba kiểm định:

Kiểm định

So sánh

Lệnh

H0

F test (cuối bảng xtreg, fe)

FE và Pooled OLS

Tự xuất hiện khi chạy xtreg, fe

Các hiệu ứng đơn vị đều bằng 0 (Pooled phù hợp)

Breusch-Pagan LM

RE và Pooled OLS

xttest0 (chạy ngay sau xtreg, re)

Phương sai hiệu ứng đơn vị bằng 0 (Pooled phù hợp)

Hausman

FE và RE

hausman fe re

RE phù hợp (không có tương quan giữa hiệu ứng riêng và biến giải thích)

xtreg roa size lev growth, re

xttest0

hausman fe re
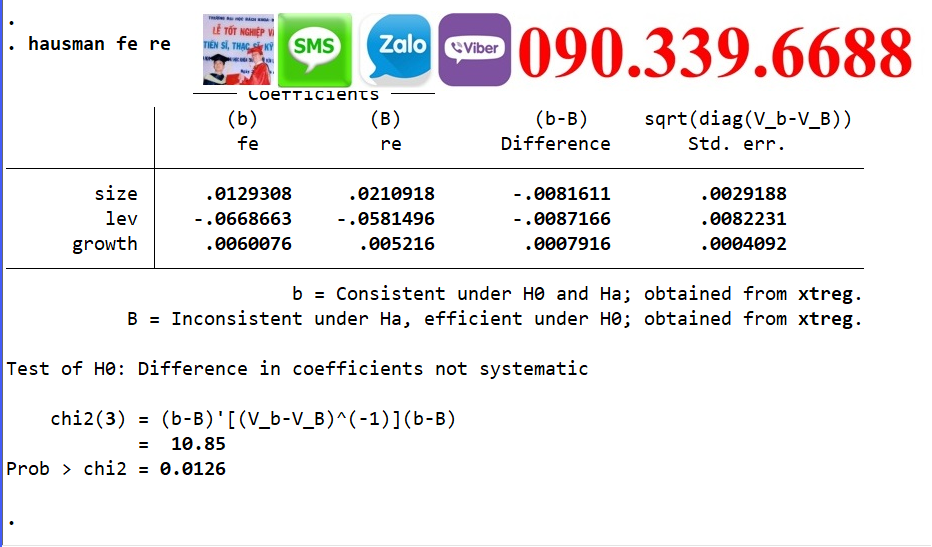
Nếu Hausman cho chi2 âm, xem bài Xử lý lỗi chi2 nhỏ hơn 0 khi kiểm định Hausman. Cách dùng chi tiết có trong bài Cách chạy kiểm định Hausman để lựa chọn giữa mô hình FE và RE.

Mẫu câu: "Kiểm định F ở cuối bảng ước lượng FE có Prob > F = 0,000 < 0,05, bác bỏ H0, do đó FE phù hợp hơn Pooled OLS. Kiểm định Breusch-Pagan LM cho Prob > chibar2 = 0,000 < 0,05, do đó RE phù hợp hơn Pooled OLS. Kiểm định Hausman cho Prob > chi2 = 0,003 < 0,05, bác bỏ H0, vì vậy mô hình tác động cố định (FE) được lựa chọn."

Bước 4. Kiểm tra đa cộng tuyến

Lệnh estat vif chỉ chạy sau regress, nên ta chạy hồi quy OLS thông thường chỉ để tính VIF (đa cộng tuyến là tính chất của các biến độc lập, không phụ thuộc vào FE hay RE):

regress roa size lev growth

estat vif

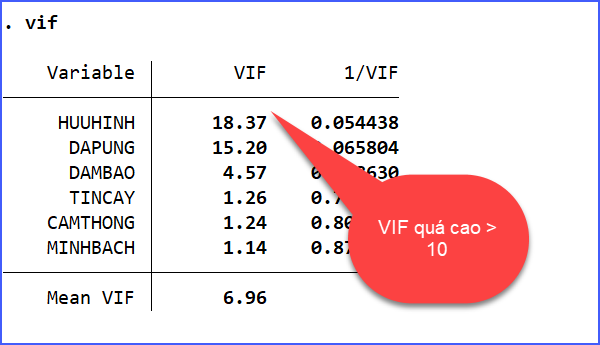
Quy ước thường dùng: VIF < 10 là chấp nhận được, chặt hơn là VIF < 5. Xem bài Đa cộng tuyến trong Stata: cách dùng lệnh vif.

Mẫu câu: "Bảng 4.4 cho thấy hệ số VIF của các biến đều nhỏ hơn 2 (VIF trung bình là 1,35), thấp hơn ngưỡng 10, do đó mô hình không có hiện tượng đa cộng tuyến nghiêm trọng." 

Bước 5. Kiểm tra phương sai sai số thay đổi

Với mô hình FE, dùng kiểm định Modified Wald (cần cài lệnh xttest3):

ssc install xttest3

xtreg roa size lev growth, fe

xttest3
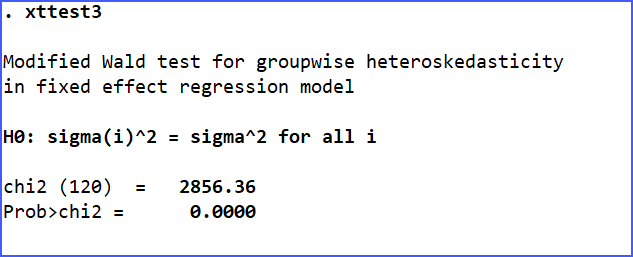
H0: phương sai sai số không đổi giữa các đơn vị. Xem thêm bài Cách cài đặt lệnh xttest3 và Phương sai của sai số thay đổi: định nghĩa, cách phát hiện, cách khắc phục.

Mẫu câu: "Kiểm định Modified Wald có Prob > chi2 = 0,000 < 0,05, bác bỏ H0, cho thấy mô hình FE có hiện tượng phương sai sai số thay đổi."

Bước 6. Kiểm tra tự tương quan

Dùng kiểm định Wooldridge (cần cài lệnh xtserial):

ssc install xtserial

xtserial roa size lev growth
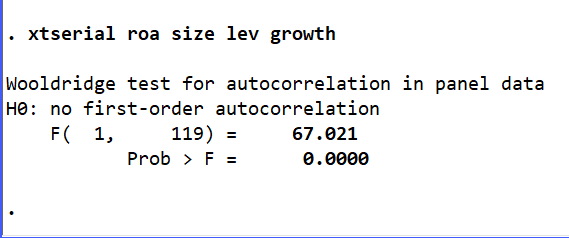
H0: không có tự tương quan bậc 1. Xem thêm bài Cách cài đặt lệnh xtserial và Kiểm định tự tương quan, tương quan chuỗi trong Stata.

Mẫu câu: "Kiểm định Wooldridge có Prob > F = 0,001 < 0,05, bác bỏ H0, cho thấy mô hình có hiện tượng tự tương quan bậc 1."

 Bước 7. Khắc phục bằng FGLS

Khi mô hình đồng thời có phương sai thay đổi và tự tương quan, ước lượng FE/RE thông thường cho sai số chuẩn không đáng tin. Hai hướng xử lý phổ biến:

Hướng 1: FGLS

xtgls roa size lev growth, panels(hetero) corr(ar1)

estimates store fgls
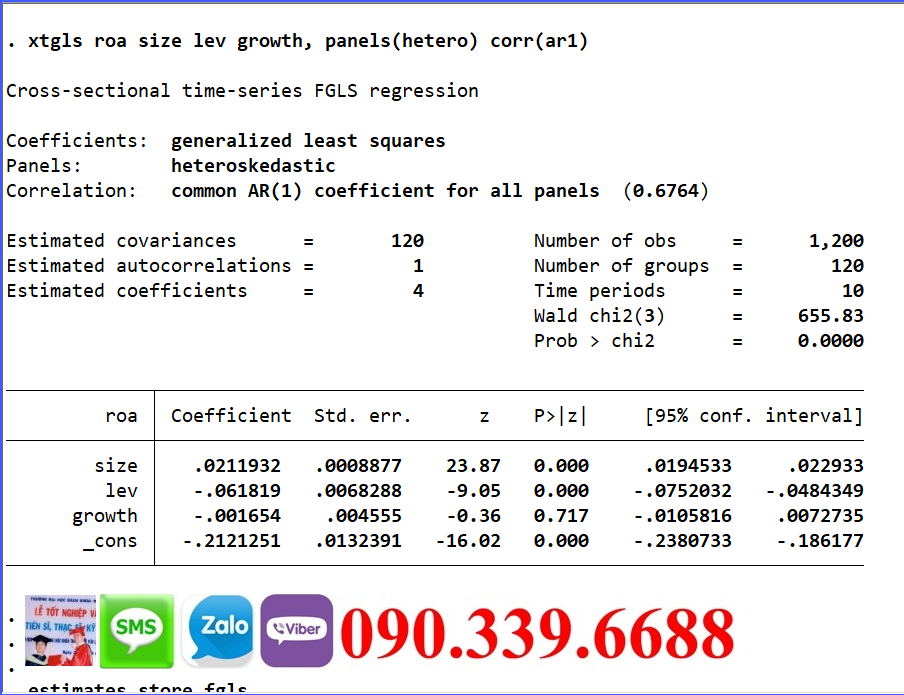
  • panels(hetero): cho phép phương sai khác nhau giữa các đơn vị
  • corr(ar1): xử lý tự tương quan bậc 1

Hướng 2: giữ FE nhưng dùng sai số chuẩn vững theo cụm

xtreg roa size lev growth, fe vce(cluster id)

estimates store fe_robust
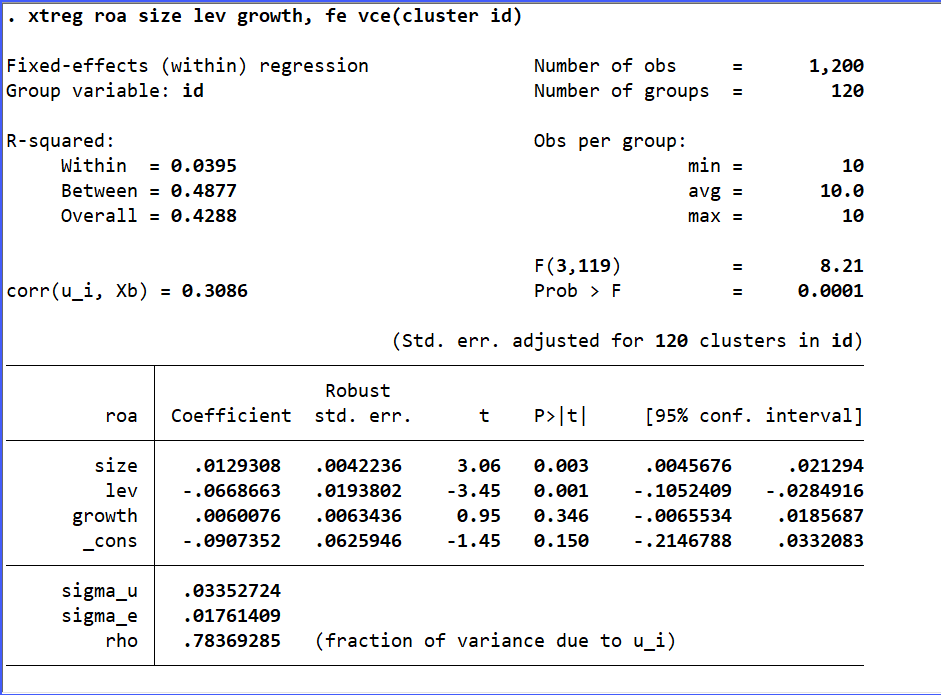
Hai lưu ý quan trọng khi dùng FGLS: (1) tùy chọn panels(correlated) chỉ dùng được khi số kỳ T lớn hơn số đơn vị N, (2) xtgls không tự khử hiệu ứng cố định như xtreg, fe. Chi tiết xem các bài FGLS trong Stata: Giải pháp cho phương sai sai số thay đổi và tự tương quan, So sánh OLS, GLS và FGLS và Khi nào KHÔNG được dùng FGLS trong Stata. Nếu bạn không chắc FGLS phù hợp, dùng vce(cluster id) là lựa chọn an toàn hơn cho mẫu có N lớn, T nhỏ.

Mẫu câu: "Do mô hình FE đồng thời vi phạm giả định về phương sai sai số không đổi và không tự tương quan, nghiên cứu sử dụng phương pháp bình phương tối thiểu tổng quát khả thi (FGLS) để khắc phục. Kết quả FGLS được sử dụng để kiểm định các giả thuyết nghiên cứu."

Bước 8. Bảng kết quả cuối cùng và diễn giải

Đặt các mô hình cạnh nhau để hội đồng dễ so sánh và thấy kết quả bền vững:

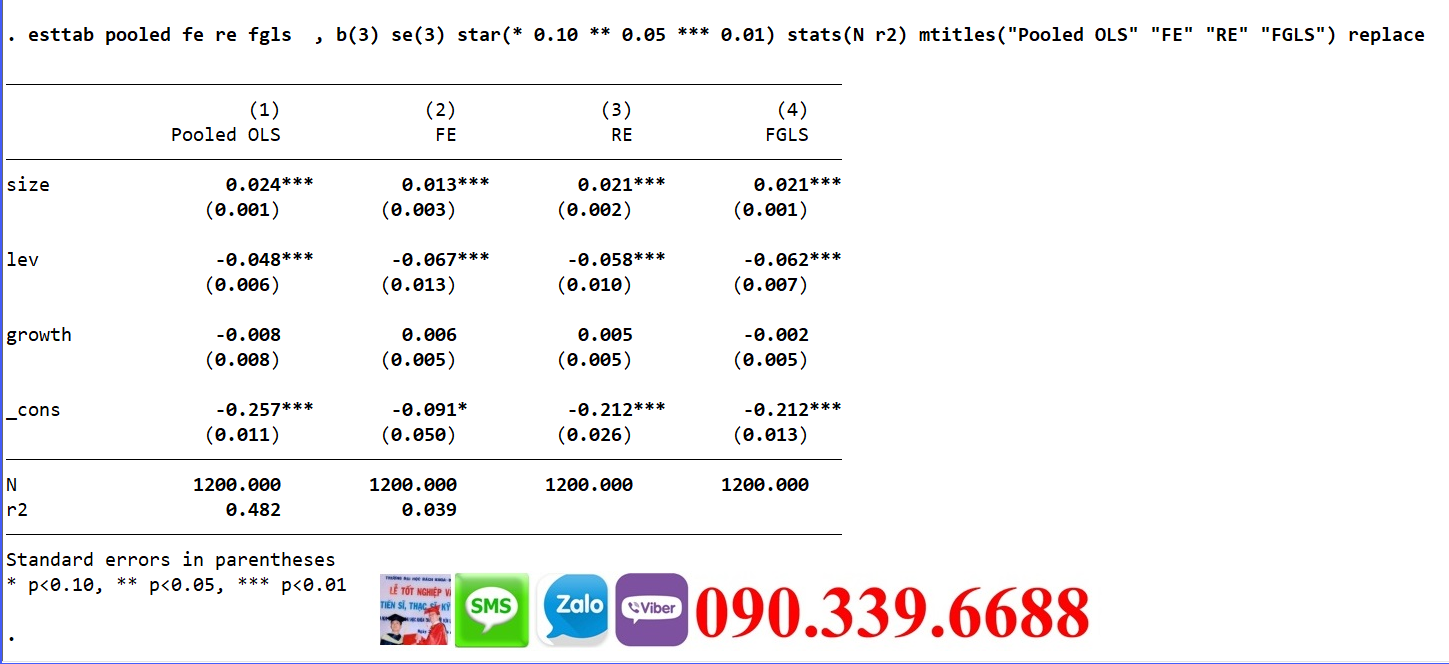
esttab pooled fe re fgls  , b(3) se(3) star(* 0.10 ** 0.05 *** 0.01) stats(N r2) mtitles("Pooled OLS" "FE" "RE" "FGLS") replace

Lưu ý: xtgls không xuất R-squared, ô này sẽ để trống, bạn ghi chú dưới bảng. Xem thêm bài Lệnh esttab.
 

5 điều cần nêu khi diễn giải mô hình cuối (FGLS)

  1. Chất lượng mô hình: Wald chi2 và p-value (mô hình có ý nghĩa tổng thể)
  2. Dấu của hệ số: cùng chiều hay ngược chiều giả thuyết
  3. Ý nghĩa thống kê: p-value hoặc số dấu sao
  4. Độ lớn tác động: "khi X tăng 1 đơn vị thì Y thay đổi b đơn vị, các yếu tố khác không đổi"
  5. Kết luận giả thuyết: ủng hộ hay không ủng hộ

Mẫu câu (biến có ý nghĩa): "Kết quả FGLS ở Bảng 4.7 cho thấy SIZE có hệ số 0,014 và có ý nghĩa thống kê ở mức 1% (p < 0,01). Khi quy mô doanh nghiệp tăng 1 đơn vị, ROA tăng trung bình 0,014 đơn vị, các yếu tố khác không đổi. Giả thuyết H1 được ủng hộ."

Mẫu câu (biến không có ý nghĩa): "Biến GROWTH có p-value = 0,27 > 0,05, do đó chưa đủ bằng chứng thống kê để kết luận biến này tác động đến ROA. Giả thuyết H3 không được ủng hộ."

Nên dùng cụm "chưa đủ bằng chứng thống kê" thay vì khẳng định "không có tác động". Nên nhắc thêm rằng kết quả FE với sai số vững và FGLS cùng dấu, cùng mức ý nghĩa (nếu đúng như vậy), vì đó là bằng chứng kết quả bền vững.

Thảo luận kết quả

Với mỗi biến chính, viết đủ ba ý: (1) kết quả của bạn, (2) so sánh với nghiên cứu trước, có trích dẫn tác giả cụ thể, (3) giải thích theo lý thuyết nền hoặc bối cảnh (ngành, quốc gia, giai đoạn).

Mẫu câu khi kết quả khác nghiên cứu trước: "Kết quả này trái với phát hiện của Nguyen (2019), có thể do khác biệt về giai đoạn nghiên cứu và đặc thù ngành trong mẫu của luận văn."

Lỗi thường gặp trong chương 4 dữ liệu bảng

  • Chỉ trình bày một mô hình mà không nói vì sao chọn FE/RE (thiếu F test, LM, Hausman)
  • Phát hiện khuyết tật nhưng không khắc phục, vẫn diễn giải kết quả FE gốc
  • Chạy FGLS mà không nêu lý do hoặc dùng panels(correlated) khi T nhỏ hơn N
  • Dán nguyên output Stata thay vì trình bày lại thành bảng có số thứ tự, tiêu đề, nguồn
  • Chỉ đọc số mà không diễn giải ý nghĩa kinh tế, quản trị
  • Kết luận không khớp giả thuyết nhưng không giải thích
  • Làm tròn số không đồng nhất giữa các bảng

Checklist trước khi nộp

☐  Có ghi rõ N (số đơn vị), T (số kỳ), tổng số quan sát, dữ liệu cân bằng hay không cân bằng

☐  Có F test, LM test, Hausman trước khi chọn mô hình

☐  Có kiểm định đa cộng tuyến, phương sai thay đổi, tự tương quan, kèm H0 và p-value

☐  Nêu rõ cách khắc phục (FGLS hoặc sai số chuẩn vững) và lý do chọn

☐  Mỗi bảng có số thứ tự, tiêu đề, nguồn và đoạn nhận xét bên dưới

☐  Kết luận từng giả thuyết rõ ràng, có so sánh với ít nhất 2 nghiên cứu trước

☐  Số liệu trong bài khớp với bảng và file Stata gốc

Nếu bạn cần hỗ trợ xử lý số liệu, chạy hồi quy hoặc kiểm định trên Stata cho luận văn, liên hệ thạc sĩ Khánh và nhóm hỗ trợ Stata qua Zalo 0903396688 hoặc email hotrostata@gmail.com.
Số liệu như thế nào là đẹp trong Stata?

1. Thế nào là một kết quả hồi quy "đẹp"?

Khi chạy hồi quy trong Stata, ta thường lo lắng khi nhìn vào bảng kết quả và thấy "không giống trong sách" hay "khác với các nghiên cứu trước". Vậy một kết quả hồi quy được xem là "đẹp" cần đáp ứng những tiêu chí nào?

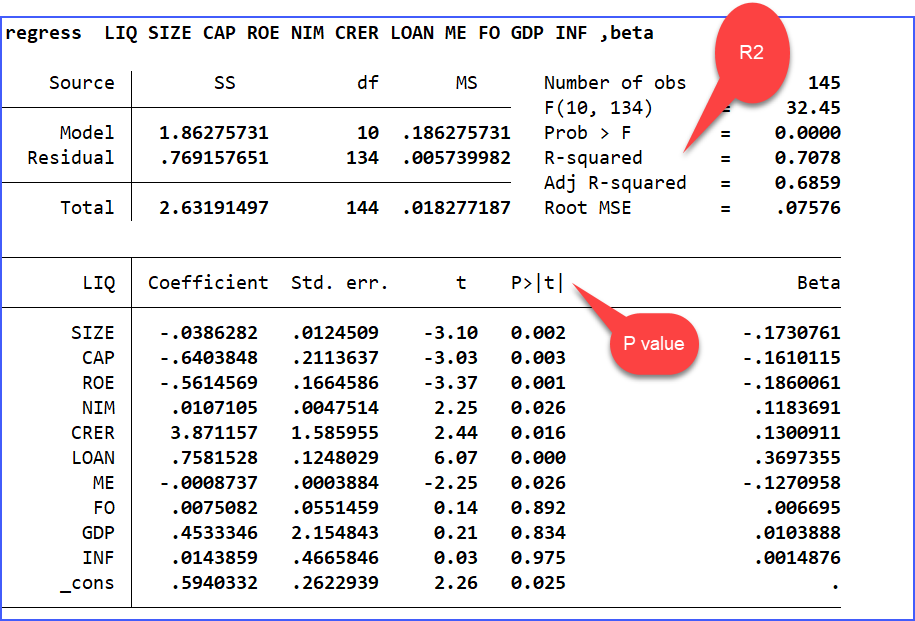
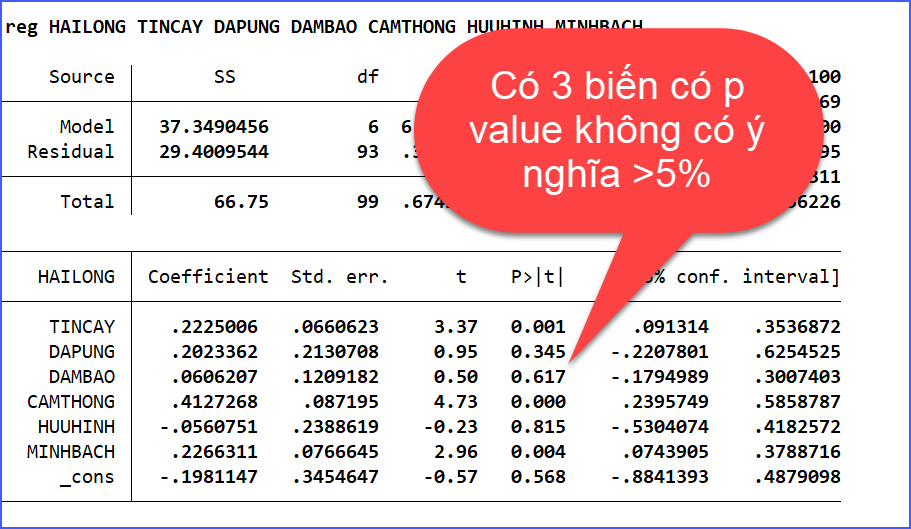
  • P-value của biến độc lập quan trọng < 5% (hoặc ít nhất < 10% với một số ngành khoa học xã hội): cho thấy biến đó có ý nghĩa thống kê trong việc giải thích biến phụ thuộc.

  • R² hoặc R² hiệu chỉnh ở mức chấp nhận được: mức "chấp nhận được" phụ thuộc vào loại dữ liệu. Với dữ liệu chuỗi thời gian hoặc dữ liệu bảng vĩ mô, R² có thể trên 0.7–0.8. Nhưng với dữ liệu chéo (cross-section) quy mô lớn, đặc biệt trong các nghiên cứu hành vi, khảo sát cá nhân, R² chỉ 0.2–0.3 vẫn hoàn toàn bình thường và được chấp nhận trong các tạp chí uy tín.
  • Dấu hệ số hồi quy đúng với kỳ vọng lý thuyết: ví dụ biến "trình độ học vấn" được kỳ vọng có tác động dương đến "thu nhập" — nếu hệ số ra âm, cần xem lại mô hình hoặc dữ liệu.
  • Không bị đa cộng tuyến nghiêm trọng (VIF < 10, tốt nhất < 5).
  • Không có phương sai sai số thay đổi hoặc tự tương quan chưa được xử lý — nếu có, cần dùng các phương pháp ước lượng phù hợp (robust standard errors, FGLS, GLS…).

Nói cách khác, "đẹp" không có nghĩa là mọi biến đều phải có p<5%, mà là kết quả phản ánh đúng bản chất dữ liệu và được ước lượng bằng phương pháp phù hợp.

2. Vì sao kết quả hồi quy bị "xấu"? 4 nhóm nguyên nhân thường gặp

Nguyên nhân 1: Mô hình chưa đúng dạng hàm

Đây là nguyên nhân phổ biến nhất nhưng lại ít được để ý. Các lỗi thường gặp:

  • Thiếu biến độc lập quan trọng (omitted variable bias), khiến mô hình không giải thích được nhiều biến động của biến phụ thuộc.
  • Sai dạng hàm: dùng dạng tuyến tính trong khi mối quan hệ thực tế là phi tuyến (cần lấy log, bình phương, hoặc thêm biến tương tác).
  • Đưa vào biến không liên quan về mặt lý thuyết, làm nhiễu mô hình.

Nguyên nhân 2: Đa cộng tuyến giữa các biến độc lập

Khi hai hay nhiều biến độc lập có tương quan cao với nhau, mô hình khó tách bạch được tác động riêng của từng biến, dẫn đến hệ số không ổn định, sai số chuẩn bị phóng đại, và p-value không có ý nghĩa dù về lý thuyết biến đó quan trọng.

Nguyên nhân 3: Cỡ mẫu nhỏ hoặc dữ liệu không đại diện

Cỡ mẫu quá nhỏ so với số biến độc lập sẽ làm giảm sức mạnh thống kê (statistical power), khiến ngay cả những tác động thực sự tồn tại cũng khó đạt được ý nghĩa thống kê ở mức p<5%.

Nguyên nhân 4: Phương sai sai số thay đổi và tự tương quan chưa xử lý

Với dữ liệu chéo, phương sai sai số thay đổi (heteroskedasticity) là hiện tượng rất phổ biến. Với dữ liệu bảng và chuỗi thời gian, tự tương quan (autocorrelation) cũng thường xảy ra. Nếu không phát hiện và xử lý, sai số chuẩn bị ước lượng sai, kéo theo p-value không đáng tin cậy.

3. Cách chẩn đoán trong Stata

Trước khi tìm cách "sửa" kết quả, cần chẩn đoán chính xác vấn đề đang gặp phải bằng các lệnh sau (sau khi chạy reg hoặc xtreg):

  • Kiểm tra đa cộng tuyến: vif
  • Kiểm tra phương sai sai số thay đổi: estat hettest hoặc lệnh kiểm định White/Breusch-Pagan
  • Kiểm tra tự tương quan với dữ liệu bảng: xtserial
  • Đọc R², R² hiệu chỉnh và p-value ngay trong bảng kết quả sau reg/xtreg

(Bạn có thể xem chi tiết cách thực hiện từng kiểm định này trong các bài viết chuyên sâu khác trên trang.)

4. Cách khắc phục đúng phương pháp

  • Loại biến gây đa cộng tuyến dựa trên cơ sở lý thuyết, không phải chọn ngẫu nhiên biến nào cho hệ số đẹp hơn.
  • Đổi dạng hàm (lấy log, thêm biến bậc hai) khi có căn cứ lý thuyết cho thấy mối quan hệ phi tuyến, không phải để "làm đẹp" R².
  • Sử dụng robust standard errors khi phát hiện phương sai sai số thay đổi, thay vì bỏ qua vấn đề.
  • Dùng FGLS/GLS khi có cả phương sai thay đổi và tự tương quan trong dữ liệu bảng.
  • Xem xét lại cỡ mẫu và cách thu thập dữ liệu nếu nghi ngờ mẫu không đại diện.

Trong trường hợp vẫn chưa ra được số liệu có ý nghĩa, hay liên  hệ dịch vụ xử lý số liệu của ThS Khánh 0903396688 và team để được xử lý triệt để bộ số liệu ra đẹp nhé.


Phân tích biến trung gian và biến điều tiết bằng Stata: Lý thuyết và thực hành chi tiết

Mediation và Moderation là gì?

Trong nghiên cứu quản trị kinh doanh, marketing hay tâm lý học, các mô hình đơn giản chỉ xét quan hệ trực tiếp giữa biến độc lập (X) và biến phụ thuộc (Y) thường không đủ để giải thích cơ chế tác động. Vì vậy, hai loại biến thường được đưa thêm vào mô hình là biến trung gian (mediator) và biến điều tiết (moderator).

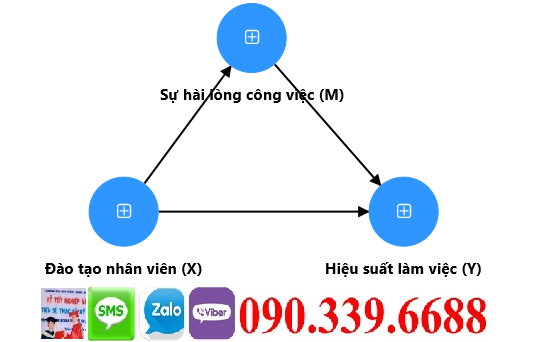
Biến trung gian (Mediator – M): là biến giải thích cơ chế mà qua đó X tác động đến Y. Nói cách khác, X tác động đến M, rồi M tác động đến Y. Ví dụ: Đào tạo nhân viên (X) → Sự hài lòng công việc (M) → Hiệu suất làm việc (Y). Ở đây sự hài lòng công việc là "cầu nối" giải thích tại sao đào tạo lại giúp tăng hiệu suất.

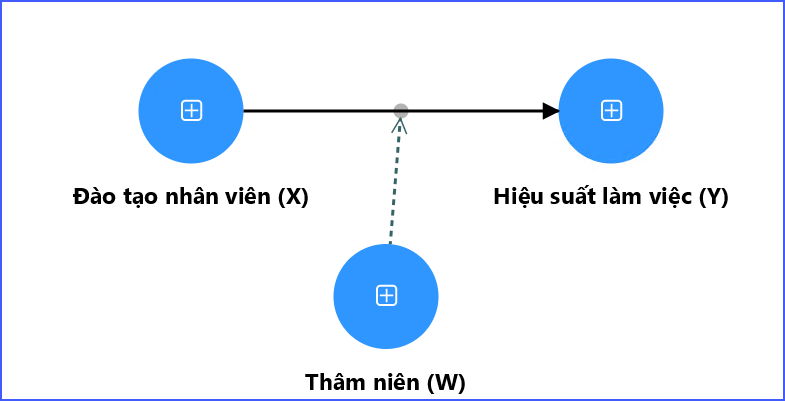
Biến điều tiết (Moderator – W): là biến làm thay đổi cường độ hoặc chiều hướng của mối quan hệ giữa X và Y. Ví dụ: mối quan hệ giữa Đào tạo (X) và Hiệu suất (Y) có thể mạnh hơn ở nhóm nhân viên có Thâm niên (W) cao, và yếu hơn ở nhóm thâm niên thấp. Thâm niên ở đây đóng vai trò điều tiết.

Nhầm lẫn giữa hai khái niệm này là lỗi rất phổ biến khi sinh viên bảo vệ luận văn, vì vậy cần phân biệt rõ trước khi đi vào thực hành trên Stata.

Phân biệt nhanh Mediation và Moderation

Tiêu chí

Biến trung gian (Mediator)

Biến điều tiết (Moderator)

Vai trò

Giải thích "tại sao" / "bằng cách nào" X tác động Y

Giải thích "khi nào" / "với ai" thì X tác động Y mạnh/yếu hơn

Vị trí trong mô hình

Nằm giữa, chịu tác động của X và tác động lên Y

Tương tác với X, không nhất thiết bị X tác động

Kiểm định phổ biến

Sobel test, Bootstrap (Preacher & Hayes)

Biến tương tác (interaction term) X*W

Câu lệnh Stata thường dùng

sem, medsem, nlcom

regress với biến tương tác, margins, marginsplot

Cách chạy phân tích biến điều tiết (Moderation) trong Stata

Đây là kỹ thuật đơn giản hơn, phù hợp làm trước. Ý tưởng: thêm biến tương tác X*W vào mô hình hồi quy.

Bước 1: Chuẩn hóa (căn giữa) biến trước khi tạo tương tác

Để tránh đa cộng tuyến giữa biến gốc và biến tương tác, nên "căn giữa" (mean-centering) biến X và W trước:

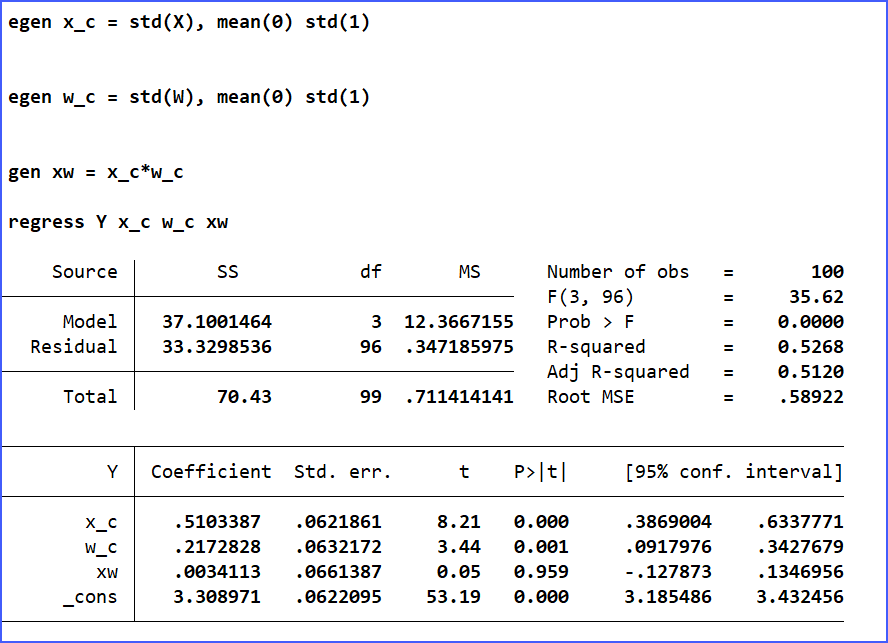
egen x_c = std(X), mean(0) std(1)

egen w_c = std(W), mean(0) std(1)

gen xw = x_c*w_c

Lưu ý về đặt tên biến khi dùng lệnh sem: Stata mặc định coi tên biến bắt đầu bằng chữ HOA là biến tiềm ẩn (latent variable) trong cú pháp sem. Vì vậy ở các mục dùng lệnh sem và medsem bên dưới, bài viết dùng tên biến chữ thường (x, m, y). Nếu bạn muốn giữ tên biến chữ hoa như X, M, Y, hãy thêm option nocapslatent vào cuối câu lệnh sem, ví dụ: sem (M <- X) (Y <- X M), method(mlmv) nocapslatent.

Bước 2: Chạy hồi quy với biến tương tác

regress Y x_c w_c xw

Nếu hệ số của xw có ý nghĩa thống kê (p < 0.05), kết luận W có vai trò điều tiết mối quan hệ giữa X và Y.

Bảng kết quả regress có biến tương tác:

Bước 3: Vẽ đồ thị điều tiết (simple slope) để diễn giải trực quan

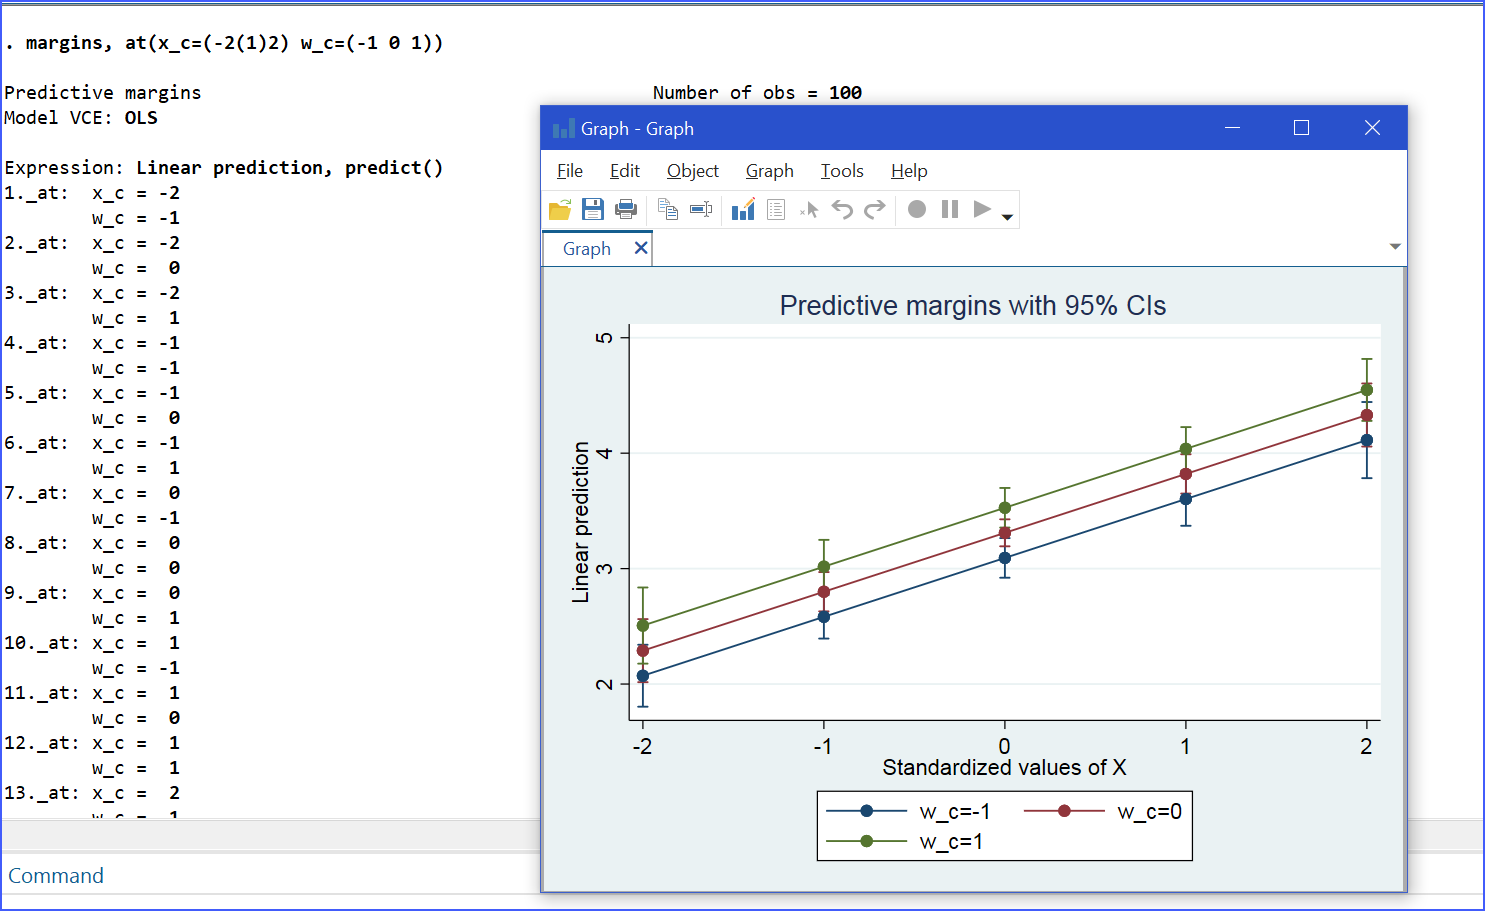
margins, at(x_c=(-2(1)2) w_c=(-1 0 1))

marginsplot

Đồ thị này cho thấy độ dốc của đường hồi quy X→Y thay đổi như thế nào ở các mức khác nhau của W (thấp – trung bình – cao), rất hữu ích khi trình bày trong chương 4 luận văn.

Đồ thị marginsplot:

Cách chạy phân tích biến trung gian (Mediation) trong Stata

Cách 1: Phương pháp Baron & Kenny (truyền thống, dễ hiểu)

Chạy 3 phương trình hồi quy riêng biệt:

* Bước 1: X tác động Y (chưa có M)

regress Y X

* Bước 2: X tác động M

regress M X

* Bước 3: X và M cùng tác động Y

regress Y X M

Nếu hệ số của X ở bước 3 giảm đi (so với bước 1) hoặc mất ý nghĩa thống kê, trong khi M có ý nghĩa, thì M đóng vai trò trung gian (trung gian một phần hoặc toàn phần).

Nhược điểm: phương pháp này không kiểm định trực tiếp ý nghĩa thống kê của "tác động gián tiếp" (indirect effect), nên hiện nay ít được các hội đồng chấm luận văn chấp nhận nếu dùng riêng lẻ.

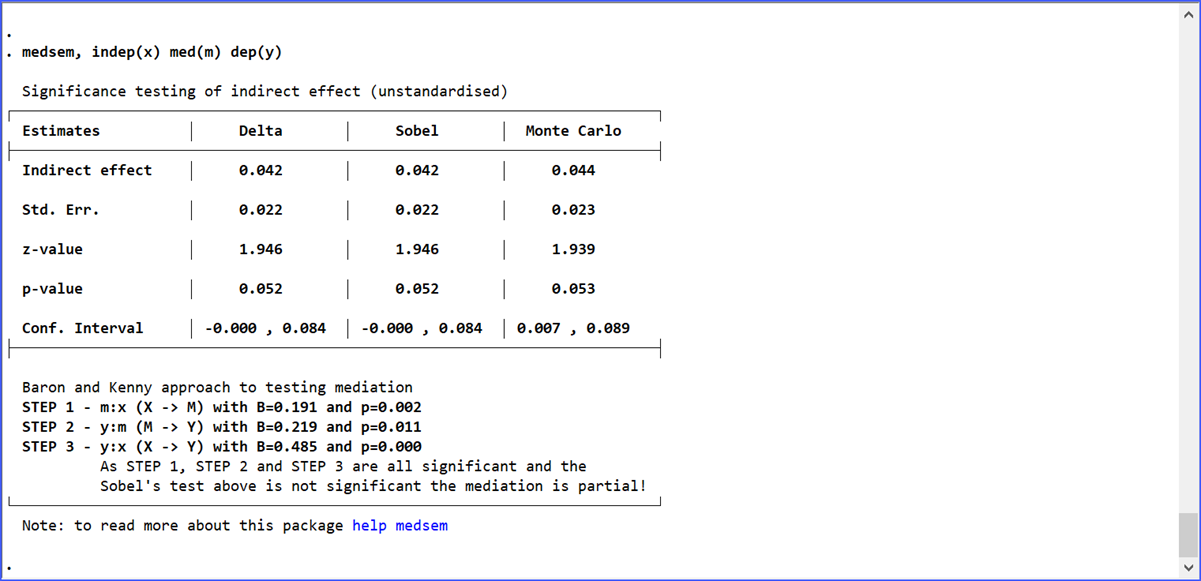
Cách 2: Bootstrap với medsem hoặc sem (khuyến nghị – chuẩn hiện nay)

Đây là cách được yêu cầu phổ biến nhất trong các luận văn hiện đại vì cho khoảng tin cậy bootstrap của tác động gián tiếp, không giả định phân phối chuẩn như Sobel test.

ssc install medsem

sem (m <- x) (y <- x m), method(mlmv)
medsem, indep(x) med(m) dep(y)

Hoặc dùng bootstrap trực tiếp:

sem (M <- X) (Y <- X M), method(mlmv)

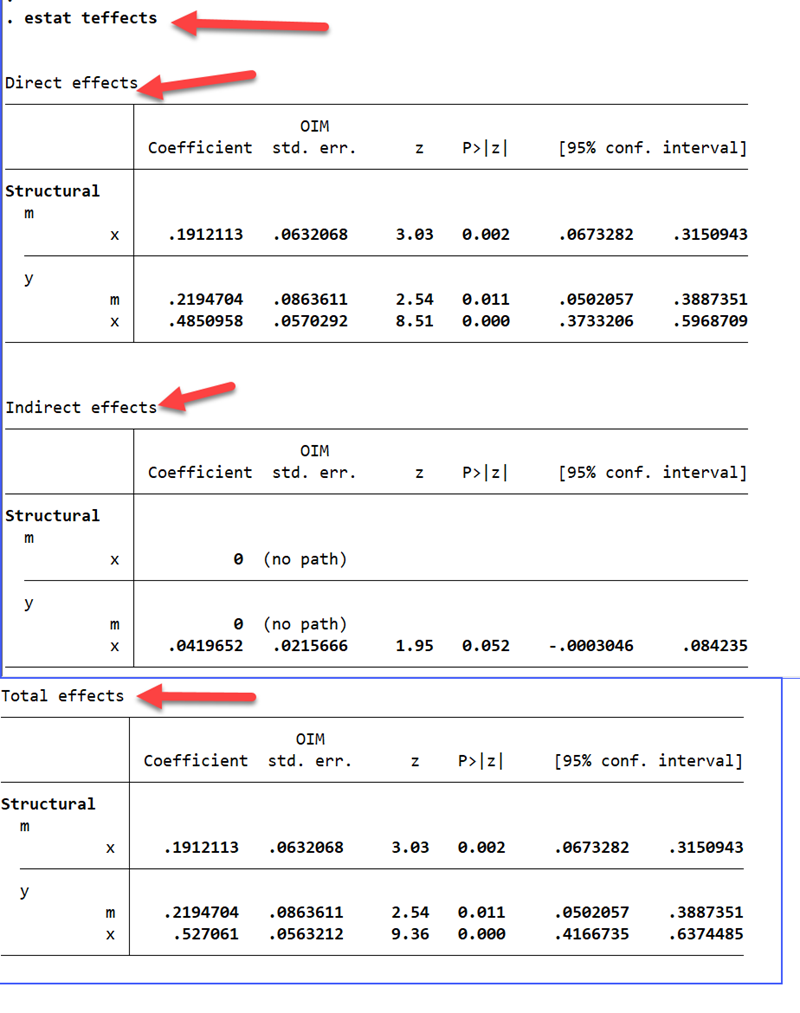
estat teffects

Kết quả estat teffects cho ra 3 chỉ số quan trọng cần báo cáo trong luận văn:

  • Direct effect: tác động trực tiếp của X lên Y (không qua M)
  • Indirect effect: tác động gián tiếp của X lên Y thông qua M (= a×b)
  • Total effect: tổng tác động = direct + indirect


Lưu ý khi trình bày trong luận văn

  • Luôn báo cáo hệ số hồi quy, sai số chuẩn, khoảng tin cậy bootstrap (thường 5000 lần lặp: bootstrap, reps(5000)) và p-value.
  • Với biến điều tiết, nên vẽ đồ thị simple slope để hội đồng dễ hình dung trực quan.
  • Với biến trung gian, cần phân biệt rõ "trung gian toàn phần" (full mediation – hệ số trực tiếp mất ý nghĩa) và "trung gian một phần" (partial mediation – hệ số trực tiếp vẫn có ý nghĩa nhưng giảm).


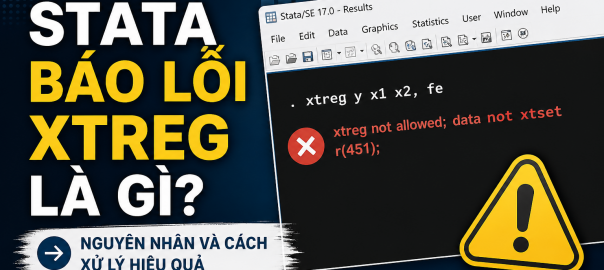
Stata báo lỗi xtreg là gì? Cách xử lý khi chạy dữ liệu bảng bị lỗi

Stata báo lỗi xtreg là gì? 

Bạn đang chạy dữ liệu bảng trong Stata, dùng lệnh xtreg nhưng phần mềm lại báo lỗi và không cho ra kết quả? Đây là một trong những tình huống rất phổ biến, đặc biệt với sinh viên làm luận văn hoặc nghiên cứu định lượng lần đầu tiếp cận data panel.

Điều khó chịu nhất là lỗi xtreg thường không nói rõ "bạn sai ở đâu", mà chỉ hiện những dòng thông báo kỹ thuật khiến bạn càng rối hơn. Nhiều người thử chạy lại nhiều lần, đổi model, thậm chí sửa dữ liệu lung tung nhưng kết quả vẫn không thay đổi. Thực tế, lỗi này không phải do một nguyên nhân duy nhất, mà thường xuất phát từ việc dữ liệu hoặc cấu trúc mô hình chưa phù hợp với yêu cầu của Stata.

Vì sao Stata báo lỗi khi dùng xtreg?

Lệnh xtreg được thiết kế để chạy hồi quy dữ liệu bảng (panel data), nghĩa là dữ liệu phải có cấu trúc theo đơn vị (id) và theo thời gian (time). Nếu một trong hai thành phần này có vấn đề, Stata sẽ không thể thực hiện hồi quy và báo lỗi ngay.

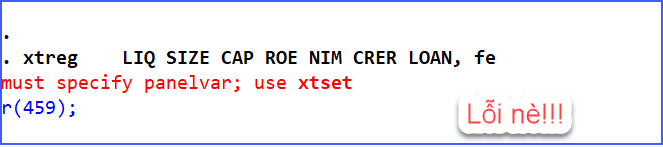
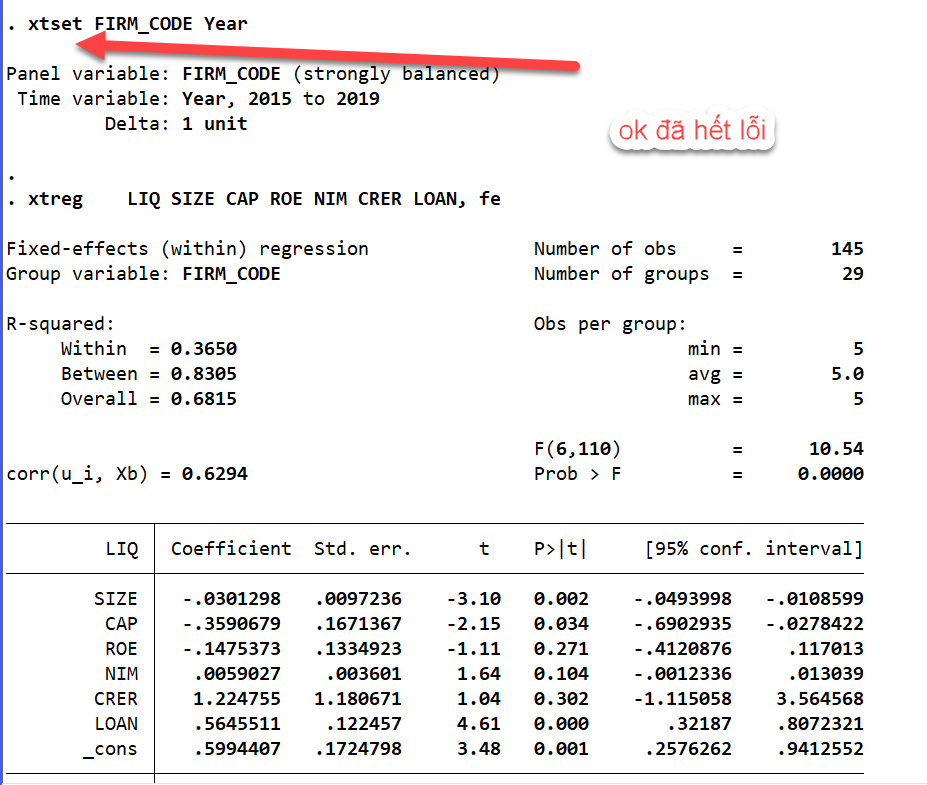
Một trường hợp rất hay gặp là bạn chưa khai báo dữ liệu bảng bằng lệnh xtset. Khi đó, Stata không biết đâu là biến đại diện cho cá thể và đâu là thời gian, dẫn đến việc xtreg không thể chạy. Ngoài ra, nếu dữ liệu bị trùng id–time hoặc thiếu giá trị ở các biến quan trọng, mô hình cũng sẽ bị lỗi. Như ảnh trên đoạn đầu: must specify panelvar; use xtset, thì sẽ hướng dẫn bạn sử dụng lệnh xtset FIRM_CODE Year. Lúc đó chương trình chạy sẽ không còn lỗi nữa.

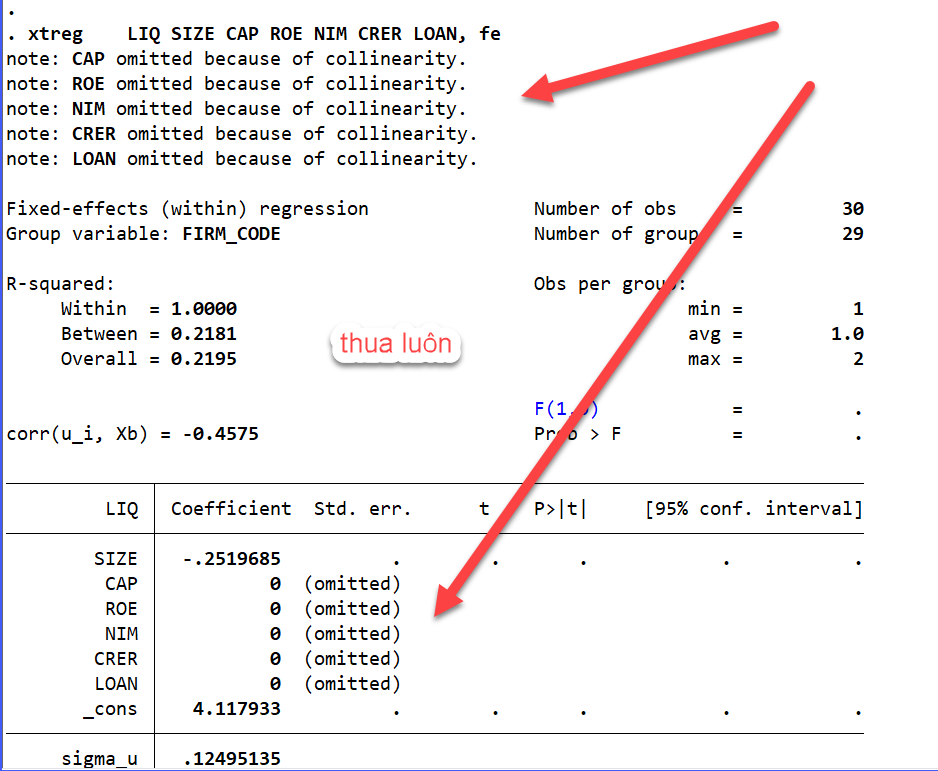
Một nguyên nhân khác sâu hơn là bản chất dữ liệu không phù hợp để chạy mô hình bạn chọn. Ví dụ, bạn cố chạy fixed effects nhưng biến độc lập lại không thay đổi theo thời gian, hoặc toàn bộ biến bị loại do đa cộng tuyến. Khi đó, Stata vẫn báo lỗi nhưng thực chất vấn đề nằm ở thiết kế nghiên cứu chứ không phải thao tác kỹ thuật.

Những lỗi xtreg phổ biến và bản chất thật phía sau

Nhiều người thấy lỗi là tìm cách sửa câu lệnh, nhưng thực tế cần hiểu bản chất vấn đề.

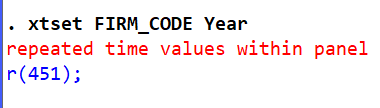
Khi Stata báo "repeated time values within panel", điều này có nghĩa là dữ liệu của bạn đang bị trùng thời gian trong cùng một đối tượng. Đây thường là lỗi nhập dữ liệu hoặc merge sai file.

Khi gặp lỗi "no observations", đa số người nghĩ dữ liệu bị mất, nhưng thực tế thường do điều kiện lọc hoặc biến bị missing quá nhiều, khiến toàn bộ mẫu bị loại khỏi mô hình.

Một dạng nguy hiểm hơn là Stata không báo lỗi rõ ràng nhưng kết quả trả về không có ý nghĩa, hoặc hệ số bị loại hết. Đây là dấu hiệu dữ liệu "có vấn đề ngầm", chẳng hạn như biến không có biến thiên hoặc mô hình sai bản chất.

Có phải cứ sửa lệnh là chạy được xtreg?

Không hẳn. Đây là sai lầm lớn nhất. Nếu nghĩ chỉ cần sửa syntax là xong, nhưng với xtreg, vấn đề thường nằm ở dữ liệu hoặc logic nghiên cứu. Bạn có thể viết đúng lệnh 100% nhưng nếu dữ liệu không phù hợp, Stata vẫn không cho kết quả hoặc cho ra kết quả "vô nghĩa".

Ví dụ, nếu bạn chạy mô hình nhưng biến phụ thuộc không thay đổi theo thời gian, thì fixed effects sẽ không hoạt động. Hoặc nếu các biến độc lập có tương quan quá cao, mô hình sẽ bị méo hoặc bị loại biến.

Khi nào bạn nên dừng tự sửa và kiểm tra lại dữ liệu?

Nếu bạn đã thử nhiều cách mà vẫn gặp lỗi xtreg, rất có thể vấn đề không còn ở thao tác nữa mà nằm ở chất lượng dữ liệu hoặc cách xây dựng mô hình.

Đây là lúc cần kiểm tra lại toàn bộ quy trình: từ cách nhập dữ liệu, mã hóa biến, cho đến việc lựa chọn mô hình hồi quy. Trong nhiều trường hợp, dữ liệu cần được xử lý lại hoặc thiết kế lại mô hình thì mới có thể chạy đúng.

Giải pháp thực tế nếu bạn đang bị lỗi xtreg

Thay vì thử sai liên tục, cách hiệu quả hơn là kiểm tra có hệ thống: xác định dữ liệu có đúng dạng panel chưa, kiểm tra trùng lặp, xem lại biến có bị thiếu hay không, và đánh giá lại mô hình đang sử dụng.

Nếu bạn không chắc lỗi nằm ở đâu hoặc đã thử nhiều cách mà vẫn không ra kết quả, khả năng cao là dữ liệu hoặc mô hình cần được xử lý chuyên sâu hơn. Bạn có thể gửi file Stata để được kiểm tra toàn diện, từ cấu trúc dữ liệu đến logic mô hình, đảm bảo chạy được xtreg và ra kết quả phù hợp với yêu cầu bài nghiên cứu.  Bạn cứ add zalo 0903396688 và gởi cho Ths Khánh xem nhé.

Kiểm định tính dừng trong dữ liệu bảng (Panel Data): Lý thuyết và ứng dụng trong Stata

Vì sao cần kiểm định tính dừng trong dữ liệu bảng?

Trong phân tích dữ liệu bảng, kiểm định tính dừng (stationarity) là một bước nền tảng nhưng lại thường bị xem nhẹ, đặc biệt là với sinh viên mới làm luận văn.

Về bản chất, tính dừng đề cập đến việc một chuỗi dữ liệu có duy trì được các đặc trưng thống kê ổn định theo thời gian hay không, bao gồm giá trị trung bình, phương sai và mối quan hệ phụ thuộc theo độ trễ. Khi dữ liệu không dừng, các mô hình hồi quy như FEM, REM hay thậm chí OLS đều có nguy cơ rơi vào tình trạng hồi quy giả mạo, tức là cho ra kết quả có vẻ rất “đẹp” về mặt thống kê nhưng hoàn toàn không phản ánh mối quan hệ thực sự giữa các biến, từ đó dẫn đến kết luận sai lệch trong nghiên cứu.

Do đó, kiểm định tính dừng là bước bắt buộc trước khi ước lượng các mô hình như FEM, REM, hay GLS.

Khái niệm tính dừng (Stationarity)

Một chuỗi dữ liệu được gọi là dừng khi:

  • Kỳ vọng (mean) không đổi theo thời gian
  • Phương sai (variance) không đổi
  • Hiệp phương sai chỉ phụ thuộc vào độ trễ, không phụ thuộc thời gian
  • Ngược lại, nếu dữ liệu có xu hướng (trend), chu kỳ hoặc biến động không ổn định thì là không dừng

Các kiểm định tính dừng phổ biến trong dữ liệu bảng

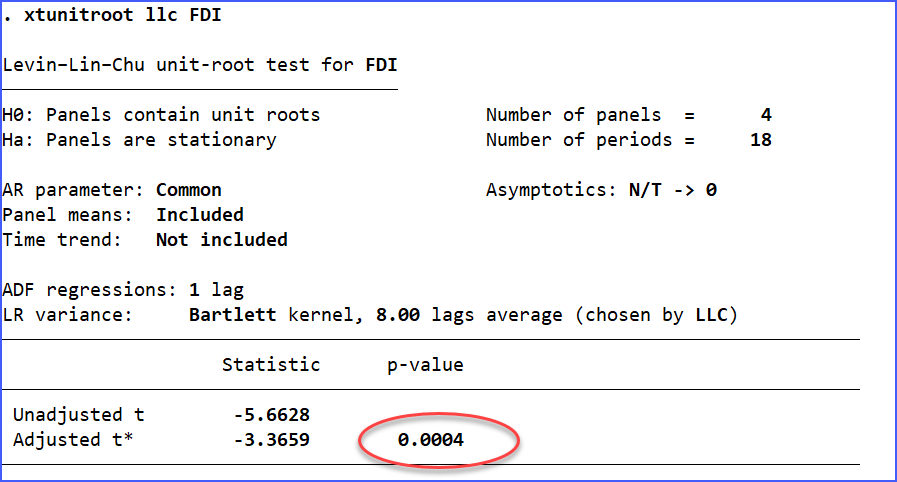
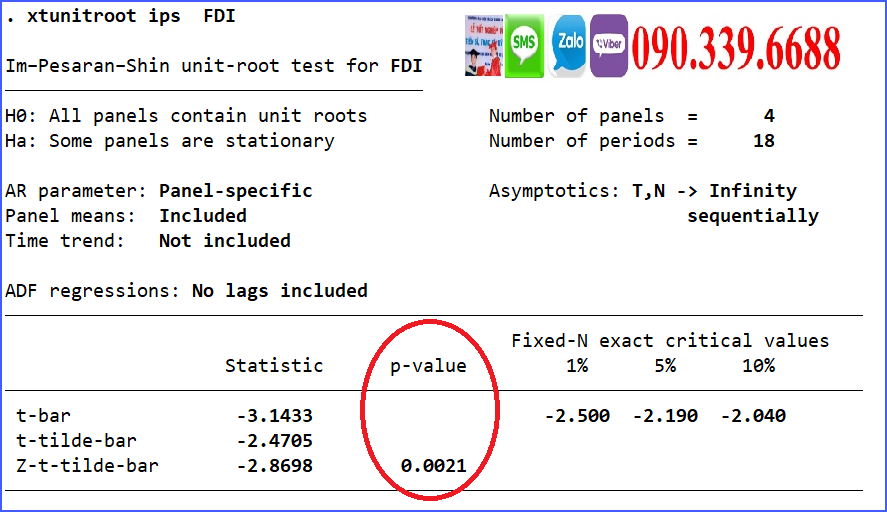
Đối với dữ liệu bảng, việc kiểm định tính dừng không thể áp dụng trực tiếp các phương pháp của chuỗi thời gian đơn mà cần sử dụng các kiểm định chuyên biệt. Một trong những kiểm định phổ biến nhất là Levin–Lin–Chu (LLC), phương pháp này giả định rằng tất cả các đơn vị trong dữ liệu bảng có cùng hệ số tự hồi quy, từ đó tăng sức mạnh kiểm định nhưng lại làm giảm tính linh hoạt. Trong khi đó, kiểm định Im–Pesaran–Shin (IPS) cho phép hệ số này khác nhau giữa các đơn vị, giúp phản ánh tốt hơn sự khác biệt giữa các quốc gia hoặc doanh nghiệp, do đó thường được sử dụng rộng rãi hơn trong thực tế. 

Kiểm định Levin–Lin–Chu (LLC)

Giả định: các đơn vị chéo (cross-section) có cùng hệ số
Phù hợp khi:N lớn, T trung bình
Giả thuyết:
H0: Có nghiệm đơn vị (không dừng)
H1: Dừng
Đặc điểm: mạnh nhưng giả định khá chặt

Kiểm định Im–Pesaran–Shin (IPS)

Cho phép hệ số khác nhau giữa các đơn vị
Linh hoạt hơn LLC
Phù hợp thực tế hơn trong nhiều nghiên cứu
Thực hiện kiểm định tính dừng trong dữ liệu bảng  trong Stata

Trong Stata, việc kiểm định tính dừng cho dữ liệu bảng được thực hiện khá đơn giản nhưng yêu cầu phải hiểu đúng quy trình. Trước tiên, cần khai báo cấu trúc dữ liệu bảng bằng lệnh xtset để xác định biến đại diện cho đối tượng và thời gian. Sau đó, có thể sử dụng các lệnh như xtunitroot llc, xtunitroot ips để thực hiện các kiểm định tương ứng. Kết quả trả về sẽ bao gồm thống kê kiểm định và giá trị p-value, từ đó ta có thể đưa ra quyết định về việc chuỗi có dừng hay không. Thông thường, nếu p-value nhỏ hơn 0.05, ta bác bỏ giả thuyết H0 và kết luận rằng chuỗi dữ liệu là dừng; ngược lại, nếu p-value lớn hơn mức ý nghĩa, chuỗi được xem là không dừng và cần được xử lý thêm trước khi đưa vào mô hình.

Cụ thể lệnh như sau:
Gán data panel: xtset id time
Kiểm định LLC : xtunitroot llc varname


Kiểm định IPS : xtunitroot ips varname
 

Cách đọc kết quả
p-value < 0.05 → bác bỏ H0 → biến dừng
p-value > 0.05 → không dừng

Và nếu biến không dừng:  Khi phát hiện biến không dừng, giải pháp phổ biến nhất là lấy sai phân bậc một để loại bỏ xu hướng và làm cho chuỗi trở nên ổn định hơn. Tuy nhiên, việc sai phân cũng đồng nghĩa với việc mất đi thông tin về mối quan hệ dài hạn giữa các biến, do đó không phải lúc nào cũng là lựa chọn tối ưu. Trong nhiều trường hợp, nếu các biến không dừng nhưng có mối quan hệ đồng liên kết, người nghiên cứu vẫn có thể sử dụng mô hình hồi quy mà không cần sai phân toàn bộ dữ liệu. Điều này đặc biệt quan trọng trong các nghiên cứu kinh tế, nơi các biến thường có xu hướng di chuyển cùng nhau trong dài hạn, và việc giữ lại thông tin này sẽ giúp mô hình phản ánh đúng bản chất của hiện tượng nghiên cứu.
Lấy sai phân bậc 1:
gen d_var = D.var
Sau đó kiểm định lại

Lưu ý quan trọng: Không phải tất cả biến đều cần dừng ở mức (level)

Ứng dụng thực tế kiểm định tính dừng

Kiểm định tính dừng được ứng dụng rộng rãi trong nhiều lĩnh vực như kinh tế học, tài chính và y tế, đặc biệt trong các nghiên cứu sử dụng dữ liệu bảng theo thời gian. Ví dụ, khi phân tích tác động của đầu tư trực tiếp nước ngoài (FDI) đến tăng trưởng kinh tế, hoặc ảnh hưởng của chi tiêu y tế đến tuổi thọ, việc đảm bảo các biến là dừng sẽ giúp kết quả nghiên cứu trở nên đáng tin cậy hơn.  
Tóm lại, kiểm định tính dừng trong dữ liệu bảng là một bước trong quy trình phân tích định lượng, đặc biệt khi sử dụng các phần mềm như Stata. Việc hiểu rõ bản chất của tính dừng, lựa chọn đúng phương pháp kiểm định và xử lý dữ liệu hợp lý sẽ giúp người nghiên cứu tránh được những sai lầm phổ biến và nâng cao chất lượng bài nghiên cứu.
 

Khi nào KHÔNG được dùng FGLS trong Stata, dù đã có phương sai thay đổi

Trong thực hành Stata,ta thường áp dụng một quy trình gần như mặc định: chạy hồi quy OLS, FEM, REM, chọn mô hình, kiểm định phương sai sai số thay đổi, nếu phát hiện heteroskedasticity thì chuyển sang FGLS để “khắc phục”. Quy trình này về mặt kỹ thuật không sai, nhưng về mặt học thuật lại có thể chưa đủ điều kiện để kết luận rằng FGLS là lựa chọn phù hợp.

Trên thực tế, nhiều tài liệu kinh tế lượng kinh điển đã chỉ ra rằng FGLS chỉ phát huy hiệu quả trong những điều kiện nhất định, và trong không ít trường hợp dữ liệu luận văn, việc dùng FGLS còn làm suy luận thống kê kém tin cậy hơn so với các phương án đơn giản hơn.
Vấn đề mấu chốt nằm ở chỗ: FGLS phụ thuộc rất mạnh vào chất lượng ước lượng cấu trúc sai số. Khi cấu trúc này không được ước lượng tốt, FGLS không những không cải thiện mô hình mà còn tạo ra kết quả “đẹp giả”, dễ bị phản biện khi đánh giá khoa học.

Trường hợp 1: Cỡ mẫu nhỏ – FGLS kém tin cậy hơn OLS/FE với robust

Trong mẫu nhỏ hoặc mẫu vừa – tình huống rất phổ biến trong luận văn thạc sĩ và nhiều nghiên cứu ứng dụng – việc ước lượng ma trận phương sai–hiệp phương sai của sai số thường không ổn định. Greene (2018) chỉ ra rằng trong bối cảnh này, FGLS có thể hoạt động kém do chính sai số trong bước ước lượng cấu trúc phương sai, khiến toàn bộ ước lượng phía sau bị ảnh hưởng. Cụ thể, ông nhấn mạnh rằng trong mẫu nhỏ, feasible GLS có thể cho kết quả kém hơn OLS vì ma trận hiệp phương sai của sai số được ước lượng với sai số lớn.
Wooldridge (2010) cũng đưa ra lập luận tương tự khi cho rằng trong nhiều nghiên cứu thực nghiệm với cỡ mẫu không lớn, việc sử dụng sai số chuẩn mạnh (robust standard errors) thường được ưu tiên hơn FGLS vì không yêu cầu phải ước lượng chính xác cấu trúc phương sai sai số. Điều này có nghĩa là, phát hiện phương sai sai số thay đổi không đồng nghĩa với việc FGLS luôn là lựa chọn tốt hơn.

Trường hợp 2: Dữ liệu panel với T nhỏ, N lớn

Trong dữ liệu bảng, đặc biệt là các nghiên cứu có số năm quan sát (T) nhỏ nhưng số đơn vị quan sát (N) lớn, việc ước lượng cấu trúc sai số theo thời gian là rất khó chính xác. Wooldridge (2010) cho rằng trong trường hợp T nhỏ, các ước lượng FGLS yêu cầu ước lượng ma trận hiệp phương sai của sai số thường hoạt động kém và dễ nhạy cảm với sai lệch mô hình.
Baltagi (2005) cũng khuyến nghị rằng với panel data dạng N lớn – T nhỏ, mô hình tác động cố định hoặc ngẫu nhiên kết hợp với sai số chuẩn mạnh thường là lựa chọn an toàn hơn so với GLS. Điều này đặc biệt quan trọng trong luận văn, nơi mục tiêu không chỉ là ước lượng mà còn là bảo vệ lập luận trước phản biện khoa học.

Trường hợp 3: Ưu tiên suy luận khoa học hơn là “đẹp số”

Một lý do khiến FGLS được sử dụng rộng rãi là vì nó thường cho sai số chuẩn nhỏ hơn và p-value “đẹp” hơn. Tuy nhiên, White (1980) đã chỉ ra rằng sai số chuẩn mạnh được thiết kế để đảm bảo suy luận thống kê hợp lệ mà không cần giả định đúng dạng heteroskedasticity. Wooldridge (2010) cũng nhấn mạnh rằng trong nhiều nghiên cứu ứng dụng, việc đảm bảo tính vững của suy luận thống kê quan trọng hơn so với việc đạt được hiệu quả ước lượng tối đa thông qua GLS khi các giả định chưa chắc chắn.
Do đó, trong bối cảnh luận văn và nghiên cứu ứng dụng, việc chấp nhận kết quả “xấu hơn một chút” nhưng suy luận đáng tin cậy hơn thường được đánh giá cao hơn việc sử dụng một mô hình phức tạp nhưng khó bảo vệ về mặt giả định.

Kết luận

Việc phát hiện phương sai sai số thay đổi là một tín hiệu quan trọng, nhưng không phải là điều kiện đủ để sử dụng FGLS. Nhiều tài liệu kinh tế lượng kinh điển đã chỉ ra rằng trong mẫu nhỏ, panel data với T nhỏ, hoặc khi cấu trúc phương sai sai số không được xác định rõ, FGLS có thể cho kết quả kém tin cậy hơn so với OLS hoặc FE/RE kết hợp với sai số chuẩn mạnh. Vì vậy, lựa chọn mô hình không nên dựa trên việc “mô hình nào xử lý được nhiều vi phạm hơn”, mà cần dựa trên mức độ phù hợp giữa giả định của mô hình và đặc điểm thực tế của dữ liệu.

Kiểm định phi tham số trong Stata, ưu nhược điểm

Có lúc dữ liệu bạn thu thập không phân phối chuẩn, hoặc chỉ ở dạng xếp hạng. Trong những tình huống đó, kiểm định phi tham số chính là lựa chọn phù hợp. Bài viết này Thạc sĩ Khánh và nhóm sẽ đi sâu vào kiểm định phi tham số, cung cấp những kiến thức cần thiết để đưa ra quyết định đúng, kèm theo ví dụ minh họa cụ thể. Bài viết này sẽ giúp bạn hiểu rõ:

  • Khi nào nên dùng kiểm định phi tham số
  • Các loại kiểm định kiểm định phi tham số phổ biến trong Stata
  • Ưu điểm và hạn chế kiểm định phi tham số
  • Ví dụ minh họa cụ thể với lệnh Stata

Kiểm định Phi tham số là gì?

Kiểm định phi tham số (Nonparametric Tests) là phương pháp thống kê không yêu cầu dữ liệu phải tuân theo phân phối chuẩn hoặc có giả định về phương sai đồng đều. Không giống như các kiểm định tham số (như t-test, ANOVA), kiểm định phi tham số làm việc trực tiếp với thứ bậc, vị trí hoặc tần suất, nên linh hoạt hơn trong các tình huống thực tế.

Thay vì dựa vào các tham số của tổng thể (như trung bình, độ lệch chuẩn), kiểm định phi tham số thường hoạt động dựa trên:

  • Thứ hạng (ranks) của dữ liệu: Sắp xếp dữ liệu từ nhỏ đến lớn và sử dụng thứ hạng thay vì giá trị thực tế.
  • Tần suất (frequencies): Đếm số lần xuất hiện của các giá trị trong các danh mục.
  • Dấu (signs): Kiểm tra sự thay đổi về dấu (tăng/giảm).

Lý do cần đến kiểm định phi tham số: dữ liệu thu thập được từ các cuộc khảo sát đôi khi không tuân theo các giả định lý tưởng. Ví dụ, thu nhập của người dân thường có phân phối lệch phải hoặc trái, hoặc điểm số đánh giá trên thang Likert 1 2 3 4 5 là dữ liệu thứ bậc, không phải định lượng thực sự. Khi đó, việc cố gắng áp dụng kiểm định tham số có thể dẫn đến kết quả sai lệch, không đáng tin cậy.

Khi nào cần sử dụng Kiểm định Phi tham số?

1. Dữ liệu không phân phối chuẩn

2. Dữ liệu dạng thứ bậc (ordinal) , chẳng hạn, dữ liệu khảo sát theo thang Likert 1–5 về mức độ hài lòng -> nên dùng kiểm định phi tham số.
3. Cỡ mẫu nhỏ (n < 30) , khi không đủ quan sát để tin tưởng các định lý giới hạn trung tâm, kiểm định phi tham số là lựa chọn an toàn hơn.
4. Dữ liệu có ngoại lệ (outliers), các giá trị bất thường dễ làm sai lệch trung bình, nên chuyển sang phương pháp dựa trên thứ bậc.

Ưu điểm của kiểm định Phi tham số

  • Không cần phân phối chuẩn , phù hợp với dữ liệu thực tế
  • Xử lý tốt dữ liệu dạng ordinal hoặc dữ liệu có outliers
  • Có thể áp dụng khi cỡ mẫu nhỏ
  • Lệnh trong Stata đơn giản, dễ thực hiện

Nhược điểm của kiểm định Phi tham số

  • Ít mạnh hơn kiểm định tham số nếu dữ liệu đã chuẩn
  • Không cung cấp các chỉ số tham số như trung bình, độ lệch chuẩn
  • Kết quả khó diễn giải về mặt thực tiễn hơn so với t-test hay hồi quy
  • Không dùng được cho các phân tích phức tạp (ví dụ: mô hình tuyến tính đa biến)

Các Kiểm định Phi tham số phổ biến

Dưới đây là một số kiểm định phi tham số mà bạn chắc chắn sẽ gặp và cần biết cách sử dụng trong quá trình làm nghiên cứu:

Kiểm định Mann-Whitney U Test (còn gọi là Wilcoxon Rank-Sum Test):

Tương đương với Independent Samples t-test trong kiểm định tham số.

Mục đích: So sánh hai nhóm độc lập khi dữ liệu không phân phối chuẩn hoặc là dữ liệu thứ bậc.
Câu lệnh: ranksum [biến_định_lượng_hoặc_thứ_bậc], by([biến_nhóm_2_giá_trị])
Ví dụ: Bạn muốn so sánh ThuNhap giữa Nam và Nữ. Giả định rằng biến ThuNhap không tuân theo phân phối chuẩn.
ranksum ThuNhap, by(gioitinh_num)

Kiểm định Wilcoxon Signed-Rank Test

Tương đương với Paired Samples t-test trong kiểm định tham số.

Mục đích: So sánh hai mẫu phụ thuộc (ghép cặp), ví dụ như đo lường trước và sau can thiệp.
Câu lệnh  signrank bien_sau_can_thiep = bien_truoc_can_thiep

Kiểm định Kruskal-Wallis H Test

Tương đương với One-way ANOVA trong kiểm định tham số.

Mục đích: So sánh ba hay nhiều nhóm độc lập.
Câu lệnh ví dụ kwallis bien_phu_thuoc, by(bien_nhom_nhieu_gia_tri)

Nếu kết quả có ý nghĩa thống kê, bạn cần thực hiện kiểm định hậu kỳ (post-hoc) để xác định cặp nhóm nào khác biệt.

Kiểm định Friedman Test

Tương đương với Repeated Measures ANOVA trong kiểm định tham số.

Mục đích: So sánh ba hay nhiều mẫu phụ thuộc (ghép cặp), ví dụ như đo lường trên cùng một đối tượng tại nhiều thời điểm khác nhau.
Câu lệnh  Stata friedman bien_thoi_diem1 bien_thoi_diem2 bien_thoi_diem3

Kiểm định Chi-squared Test (Kiểm định Chi bình phương)

Mục đích: Kiểm tra mối liên hệ giữa hai biến định danh (phân loại).
Câu lệnh  Stata tabulate bien_dinh_danh_1 bien_dinh_danh_2, chi2

Hệ số tương quan hạng Spearman

Mục đích: Đo lường mức độ và chiều hướng của mối quan hệ đơn điệu giữa hai biến định lượng hoặc thứ bậc.
Câu lệnh  spearman bien_1 bien_2

Hãy tiếp tục theo dõi phantichstata.com để khám phá các bài viết chi tiết hơn về cách thực hiện từng kiểm định này trên phần mềm nhé

Sử dụng NotebookLM để tổng hợp cơ sở lý thuyết cho luận văn ứng dụng Stata

Trong quá trình làm luận văn hoặc nghiên cứu khoa học, việc tổng hợp cơ sở lý thuyết luôn là một trong những khâu “gian nan” nhất. Người học thường phải dành hàng giờ, thậm chí hàng tuần để đọc hàng loạt tài liệu, lọc ra những phần phù hợp và sắp xếp sao cho mạch lạc, nhất quán với mục tiêu nghiên cứu. Điều này không chỉ tốn công mà còn gây áp lực, vì giảng viên có thể truy vấn sâu như: "Nguồn lý thuyết này từ đâu?", "Có nghiên cứu nào trước đó đề cập không?", hay "Kết quả trước đây có gì liên quan đến đề tài hiện tại?".

Trước đây, việc này hoàn toàn phụ thuộc vào khả năng đọc hiểu và sắp xếp tài liệu thủ công. Nhưng giờ đây, với sự hỗ trợ từ trí tuệ nhân tạo, mọi thứ đã thay đổi. Thạc sĩ Khánh cùng nhóm cộng sự đã ứng dụng NotebookLM, một công cụ AI do Google phát triển, để giúp xử lý và hệ thống hóa các bài báo học thuật một cách hiệu quả. Bài viết dưới đây chia sẻ cách mà nhóm đã tận dụng công cụ này, với hy vọng bạn có thể rút ngắn đáng kể thời gian làm phần lý thuyết cho luận văn – mà vẫn đảm bảo được chiều sâu học thuật cần thiết.

NotebookLM là gì?

NotebookLM là một trợ lý nghiên cứu ứng dụng trí tuệ nhân tạo (AI) do Google phát triển, có khả năng phân tích và hiểu nội dung của các tài liệu bạn cung cấp – bao gồm PDF, Google Docs, hoặc Word. Sau khi bạn tải tài liệu lên, NotebookLM sẽ trở thành một "người bạn học" cực kỳ thông minh: bạn có thể đặt bất kỳ câu hỏi nào liên quan đến nội dung tài liệu, và hệ thống sẽ phản hồi chính xác dựa trên chính nguồn đó – không tự bịa, không lan man như nhiều chatbot thông thường.

Bạn có thể truy cập trực tiếp tại: https://notebooklm.google.com

Ví dụ: bạn muốn biết lý thuyết A được nêu ở trang nào, thuộc nghiên cứu của tác giả nào, hay mô hình nghiên cứu B đã từng được sử dụng trong bài nào chưa – chỉ cần hỏi NotebookLM, và bạn sẽ nhận được câu trả lời kèm trích dẫn cụ thể.
Điểm mạnh của NotebookLM

  • Xử lý hàng trăm trang tài liệu một cách hiệu quả, phù hợp với những bạn đang thu thập nhiều bài báo cho phần tổng quan lý thuyết.
  • Tạo workspace linh hoạt, có thể phân tích, đối chiếu nhiều tài liệu trong cùng một không gian làm việc.
  • Trả lời chính xác các câu hỏi học thuật, nhờ vào việc bám sát nội dung tài liệu gốc.
  • Hỗ trợ cả tiếng Việt lẫn tiếng Anh, không yêu cầu phải chuyển đổi ngôn ngữ hay định dạng.

Tại sao nên dùng NotebookLM để tổng hợp cơ sở lý thuyết?
Những khó khăn thường gặp khi viết phần lý thuyết:

  • Không biết chọn tài liệu nào là phù hợp với đề tài.
  • Phải đọc thủ công quá nhiều bài báo, mất thời gian.
  • Khó khăn trong việc diễn đạt lại lý thuyết theo văn phong khoa học.
  • Dễ bị cuốn vào sao chép ý tưởng mà không hiểu bản chất mô hình.

NotebookLM hỗ trợ bạn như thế nào?

  • Xác định và trích xuất các khái niệm, mô hình và lý thuyết từ tài liệu đã tải lên.
  • Tự động tóm tắt phần quan trọng, giúp bạn dễ dàng nắm bắt nhanh nội dung cốt lõi.
  • So sánh và đối chiếu mô hình giữa các bài viết, bạn chỉ cần hỏi: “Bài nào sử dụng mô hình FGLS?” – và AI sẽ tìm giúp.
  • Gợi ý cách nhóm và trình bày lý thuyết một cách logic, tạo nền tảng để viết phần tổng quan mạch lạc và có chiều sâu.

Hướng dẫn sử dụng NotebookLM để tổng hợp cơ sở lý thuyết cho nghiên cứu

Dưới đây là các bước chi tiết để bạn sử dụng NotebookLM hỗ trợ tổng hợp lý thuyết từ hàng loạt tài liệu học thuật, giúp rút ngắn thời gian chuẩn bị cho phần tổng quan nghiên cứu.

Bước 1: Chuẩn bị tài liệu đầu vào

Trước tiên, bạn cần thu thập các bài báo, luận văn hoặc nghiên cứu học thuật liên quan đến đề tài của mình. Một số nguồn tài liệu đáng tin cậy gồm:

  • Google Scholar
  • Scopus
  • Semantic Scholar
  • Và các luận văn, bài báo liên quan bằng tiếng Việt cũng được

Ưu tiên chọn các tài liệu có chỉ số trích dẫn cao, được đăng trên các tạp chí uy tín.

Tải về dưới dạng PDF hoặc lưu trực tiếp trên Google Docs để thuận tiện sử dụng với NotebookLM.

Bước 2: Truy cập và nạp tài liệu vào NotebookLM

Truy cập: https://notebooklm.google.com

Đăng nhập bằng tài khoản Google cá nhân.

Nhấn "+ Create New" để tạo một workspace mới.

Ví dụ tên workspace:
"Cơ sở lý thuyết – Luận văn Kiều hối, Năng lực cạnh tranh & Căn bệnh Hà Lan tại Việt Nam"

Chọn "Upload files" hoặc "Import from Google Drive" để nạp tài liệu.

Bước 3: Đặt câu hỏi và khai thác thông tin từ tài liệu

Sau khi tài liệu được tải lên, bạn có thể bắt đầu trò chuyện với NotebookLM để truy vấn thông tin học thuật. Một số câu hỏi gợi ý như:

"Trong các tài liệu đã tải, có mô hình nghiên cứu nào được trình bày không? Hãy mô tả chi tiết."

"Tóm tắt nội dung liên quan đến Lý thuyết Căn bệnh Hà Lan (Dutch Disease Theory)."

"Tài liệu nào sử dụng thang đo Likert 5 điểm?"

"So sánh các lý thuyết nền được sử dụng trong ba bài nghiên cứu gần đây nhất."

Bạn có thể đặt câu hỏi bằng tiếng Việt hoặc tiếng Anh – NotebookLM đều có thể xử lý và trả lời chính xác dựa trên nội dung bạn đã nạp vào.
Ghi chú: Nên đặt nhiều câu hỏi theo các khía cạnh khác nhau: lý thuyết nền, mô hình nghiên cứu, biến quan sát, thang đo, phương pháp phân tích…Tạo "Note" ngay trong NotebookLM để lưu lại các phần nội dung quan trọng cho quá trình viết bài.

 Ví dụ sau đây là yêu cầu hỏi và trả lời nhé.

Câu hỏi:hãy trả lời bằng tiếng việt, Tóm tắt nội dung liên quan đến Lý thuyết Căn bệnh Hà Lan (Dutch Disease Theory)


Câu trả lời, quá là tuyệt vời luôn:

Dựa trên các nguồn đã cung cấp, dưới đây là tóm tắt nội dung liên quan đến Lý thuyết Căn bệnh Hà Lan (Dutch Disease Theory):

Lý thuyết Căn bệnh Hà Lan (Dutch Disease Theory) mô tả một hiện tượng kinh tế trong đó sự bùng nổ của một ngành kinh tế (thường là ngành xuất khẩu tài nguyên) hoặc một luồng vốn ngoại tệ lớn đổ vào có thể gây ra những tác động tiêu cực đến các ngành kinh tế khác, đặc biệt là các ngành sản xuất hàng hóa có thể giao thương (tradable goods) như công nghiệp chế biến.

Ban đầu, khái niệm này được đặt tên theo trải nghiệm của Hà Lan vào những năm 1960 sau khi phát hiện các mỏ khí đốt tự nhiên lớn, dẫn đến sự tăng giá mạnh của đồng tiền nước này và làm suy yếu ngành sản xuất truyền thống. Tuy nhiên, lý thuyết này đã được mở rộng và áp dụng cho tác động của bất kỳ luồng ngoại tệ lớn nào, bao gồm viện trợ nước ngoài, đầu tư trực tiếp nước ngoài (FDI), và đặc biệt là kiều hối.

Cơ chế chính của Căn bệnh Hà Lan hoạt động thông qua hai hiệu ứng:

  • Hiệu ứng Chi tiêu (Spending Effect): Dòng vốn ngoại tệ lớn (như kiều hối) làm tăng thu nhập trong nước và tổng cầu. Sự gia tăng chi tiêu này thường tập trung vào các mặt hàng và dịch vụ không thể giao thương (non-tradable) như dịch vụ, bất động sản. Điều này dẫn đến việc giá cả các mặt hàng không thể giao thương tăng lên. Do giá các mặt hàng có thể giao thương được neo vào thị trường quốc tế, sự tăng giá tương đối của hàng hóa không thể giao thương dẫn đến sự tăng giá của tỷ giá hối đoái thực (Real Exchange Rate – REER).
  • Hiệu ứng Dịch chuyển Nguồn lực (Resource Movement Effect): Lợi nhuận cao hơn trong ngành hàng hóa/dịch vụ không thể giao thương thu hút các yếu tố sản xuất như lao động và vốn dịch chuyển từ các ngành có thể giao thương sang.

Tỷ giá hối đoái thực tăng giá làm cho hàng xuất khẩu của quốc gia trở nên đắt hơn và hàng nhập khẩu rẻ hơn, từ đó làm giảm khả năng cạnh tranh của các ngành sản xuất hàng hóa có thể giao thương trên thị trường quốc tế. Sự kết hợp của hai hiệu ứng này có thể dẫn đến sự suy giảm sản lượng và việc làm trong các ngành có thể giao thương, đôi khi được gọi là "phi công nghiệp hóa".

Các nghiên cứu chỉ ra rằng tác động của Căn bệnh Hà Lan đối với tăng trưởng kinh tế có thể là tiêu cực. Đặc biệt, nếu khu vực có thể giao thương là nguồn chính của sự đổi mới công nghệ và học hỏi kinh nghiệm ("learning-by-doing"), việc suy giảm ngành này có thể ảnh hưởng đến năng suất và tăng trưởng dài hạn.

Tuy nhiên, tác động của Căn bệnh Hà Lan không phải lúc nào cũng xảy ra và có thể phụ thuộc vào nhiều yếu tố như:

  • Phản ứng chính sách vĩ mô: Cách chính phủ quản lý dòng vốn và tỷ giá hối đoái có thể làm giảm nhẹ hoặc tăng cường tác động.
  • Cách sử dụng dòng vốn: Nếu dòng vốn (như kiều hối) được hướng vào đầu tư sản xuất thay vì chỉ tiêu dùng, chúng có thể thúc đẩy tích lũy vốn và tăng năng lực sản xuất. Hiệu ứng tích lũy vốn này có thể bù đắp các tác động tiêu cực ban đầu và hỗ trợ tăng trưởng dài hạn.
  • Sự phát triển của thị trường tài chính và các chính sách hỗ trợ ngành có thể giao thương.

Các nguồn cung cấp đã áp dụng lý thuyết Căn bệnh Hà Lan để phân tích tác động của kiều hối ở nhiều quốc gia đang phát triển, bao gồm các nước ở Châu Âu, Châu Á (đặc biệt là Việt Nam), Châu Mỹ Latinh và Caribe, cũng như Pakistan, Bangladesh, Nepal. Các nghiên cứu này sử dụng nhiều phương pháp định lượng khác nhau để kiểm chứng sự tồn tại và mức độ của Căn bệnh Hà Lan trong bối cảnh kiều hối.

Trung bình, trung vị và mode: So sánh, công thức và ví dụ dễ hiểu

1. Giới thiệu trung bình, trung vị, mode

Trong thống kê mô tả, trung bình (mean), trung vị (median) và mode là 3 chỉ số trung tâm phổ biến nhất. Việc hiểu rõ từng khái niệm giúp bạn:

  • Tóm tắt dữ liệu hiệu quả
  • Phân tích dữ liệu chính xác hơn
  • Lựa chọn công cụ phân tích phù hợp trong Stata hoặc Excel

2. Khái niệm và công thức Trung bình (Mean) 

Định nghĩa: Là giá trị tổng của tất cả các quan sát chia cho số lượng quan sát.
Công thức:
Trung bình = (tổng giá trị các quan sát) /(số lượng quan sát)
Ví dụ: Điểm của 5 học sinh là: 6, 7, 8, 9, 10
Mean=(6+7+8+9+10)/5=8 , như vậy điểm trùng bình của nhóm học sinh này là 8 điểm.

3. Khái niệm và công thức Trung vị (Median)

Định nghĩa: Là giá trị đứng giữa khi sắp xếp các quan sát theo thứ tự tăng dần.
Nếu số lượng là lẻ, median là số ở giữa.
Nếu số lượng là chẵn, median là trung bình của hai số giữa.
Ví dụ:

  • Chuỗi số 6, 7, 8, 9, 10 thì trung vị = 8
  • Chuỗi số 6, 7, 8, 9 thì trung vị = (7+8)/2 = 7.5

4. Khái niệm và công thức Mode

Mode =Giá trị thường gặp nhất.
Định nghĩa Mode: là giá trị xuất hiện nhiều nhất trong tập dữ liệu.
Ví dụ: 6, 7, 7, 8, 9 thì Mode = 7
Nếu mọi giá trị xuất hiện 1 lần thì không có mode

5. So sánh Trung bình – Trung vị – Mode

  • Trung bình, bị ảnh hưởng bởi ngoại lệ, dễ tính toán, phù hợp với loại biến số lượng (liên tục), khả năng tóm tắt dữ liệu kém chính xác
  • Trung vị, không bị ảnh hưởng bởi ngoại lệ, dễ tính toán, phù hợp với loại biến thứ tự hoặc liên tục, khả năng tóm tắt dữ liệu tốt hơn
  • Mode, không bị ảnh hưởng bởi ngoại lệ, dễ tính toán, phù hợp với loại biến danh mục hoặc số, có thể có nhiều mode

6. Ví dụ thực tế trung bình, trung vị và mode về thu nhập hàng tháng

Dữ liệu thu nhập của 7 người (triệu đồng): 5, 6, 6, 7, 7, 8, 100
Trung bình Mean = (5 + 6 + 6 + 7 + 7 + 8 + 100) / 7 = 19.86
Trung vị Median = 7
Mode = 6 và 7 (cùng xuất hiện 2 lần). Nghĩa là có thể có nhiều giá trị mode nhé
Nhưng trung bình bị lệch do thu nhập quá lớn (100 triệu). Trung vị thể hiện mức trung tâm thực tế tốt hơn. Đây là điều đáng lưu ý.

Ví dụ này được chạy ở phần 8 dưới đây bằng Stata nhé.

7. Khi nào dùng cái nào trung bình, trung vị và mode?

  1. Trung bình: Khi dữ liệu không hoặc ít có giá trị ngoại lệ
  2. Trung vị: Khi dữ liệu lệch, có ngoại lệ (vd: thu nhập, giá nhà)
  3. Mode: Khi muốn tìm giá trị phổ biến nhất (vd: size giày phổ biến, màu yêu thích)

8. Câu lệnh tìm trung bình, trung vị và mode trong Stata

Trong Stata sử dụng lệnh 
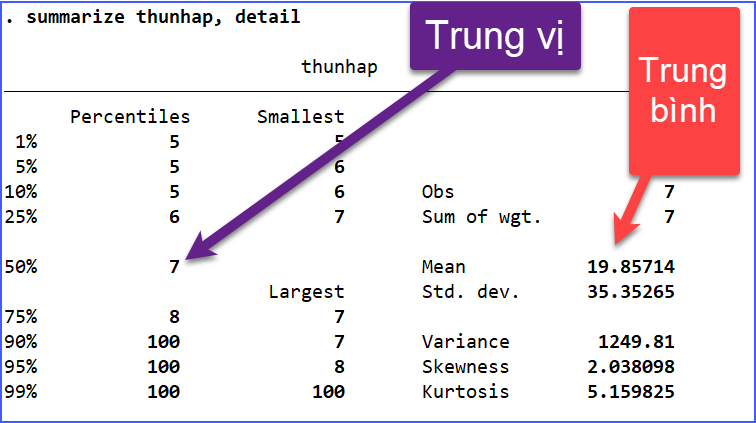
summarize thunhap, detail   ( để tìm mean và median- thunhap là tên biến)

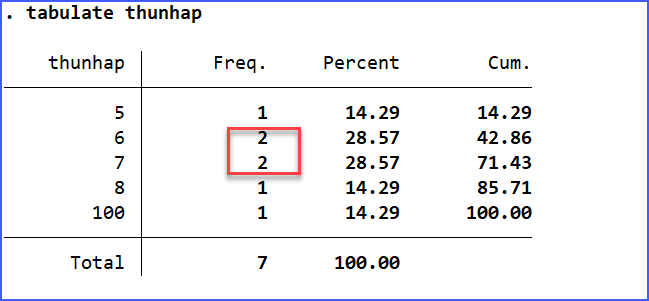
tabulate thunhap ( để tìm mode- thunhap là tên biến)

Ví dụ bạn mở stata lên và nhập các giá trị sau vào ô command để tạo bộ số liệu thu nhập:

clear
input thunhap
5
6
6
7
7
8
100
end

Sau đó gõ tab để xác định mode

tabulate thunhap

Giá trị nào có tần suất cao nhất chính là mode. Ở đây mode = 6 và 7 (cùng tần suất cao nhất: 2 lần)

Ngoài ra trung bình là 19.8 và trung vị là giá trị ở mức 50% percentile, chính là giá trị 7

Kết luận
Việc hiểu rõ sự khác nhau giữa trung bình, trung vị và mode sẽ giúp bạn lựa chọn phương pháp mô tả phù hợp và tránh sai lệch trong phân tích.

Nếu bạn cần hỗ trợ thêm về việc chạy mô hình hoặc xử lý số liệu, đừng ngần ngại liên hệ với ThS Khánh( nhóm MBA Bách Khoa) qua các kênh sau:

-Zalo 0903396688 phone no

-Facebook  facebook.com/hotroStata

Ứng dụng kiểm định T-test trong nghiên cứu y tế bằng Stata

Trong các bài nghiên cứu y tế mà ThS Khánh và team làm thường xuyên, mục đích thường là so sánh sự khác nhau giữa hai nhóm đối tượng: nhóm điều trị và nhóm chứng, hoặc trước và sau can thiệp, hoặc nam và nữ. Trong những tình huống như vậy, kiểm định t-test được dùng để xác định xem trung bình của hai nhóm có khác nhau về mặt thống kê hay không.

1. Tại sao T-test quan trọng trong nghiên cứu y tế?

Trong nghiên cứu y tế, các chỉ số như huyết áp, nồng độ cholesterol, BMI, hoặc mức độ hài lòng với chất lượng dịch vụ… được sử dụng như biến phụ thuộc. Việc so sánh giá trị trung bình giữa hai nhóm để đánh giá tác động của một yếu tố can thiệp (thuốc, phương pháp điều trị, giáo dục sức khỏe…) rất cần đến kiểm định T-test.

2. Phân loại các loại T-test trong Stata

T-test    Tình huống sử dụng    Lệnh trong Stata

  1. Loại T-test 1 mẫu (One-sample):So sánh trung bình với giá trị cố định, ví dụ muốn test chỉ số BMI có bằng 23 không thì sử dụng lệnh: ttest bmi = 23
  2. Loại T-test 2 mẫu độc lập: So sánh trung bình giữa hai nhóm không liên quan, ví dụ muốn test có sự khác biệt về BMI giữa 2 nhóm giới tính khác nhau thì dùng lệnh: ttest bmi, by(gioitinh)
  3. Loại T-test có ghép cặp (Paired):So sánh giá trị trước và sau ở cùng đối tượng, ví dụ so sánh huyết sắc tố  Hemoglobin A của 1 nhóm người ở hai thời điểm khác nhau thì sử dụng lệnh ttest hba1c_truoc = hba1c_sau

3. Ví dụ 1: Kiểm định T-test 2 mẫu trong nghiên cứu huyết áp

Tải có dữ liệu về huyết áp tối đa (SBP) của 100 bệnh nhân, trong đó 50 người được dùng thuốc A và 50 người dùng giả dược (placebo). Tải tại đây https://phantichstata.com/filedownload/huyetap.dta

Biến: sbp = huyết áp tối đa

Biến: nhom = 1 (thuốc A), 0 (placebo)  

use huyetap.dta, clear
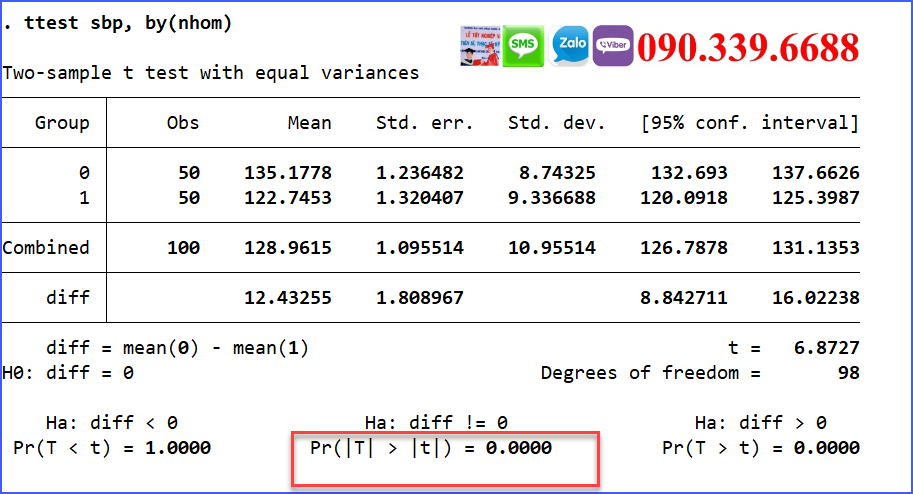
ttest sbp, by(nhom)


Diễn giải kết quả t-test
Null hypothesis (H0): Trung bình huyết áp hai nhóm bằng nhau.
Kết quả: p-value < 0.05, ta bác bỏ H0 và kết luận huyết áp trung bình khác nhau giữa hai nhóm.

4. Ví dụ 2: T-test có ghép cặp (paired T-test) trước và sau can thiệp

Chỉ số HbA1c trước và sau khi áp dụng một chương trình dành cho bệnh nhân tiểu đường nằm trong file sau, bạn tải về nhé: https://phantichstata.com/filedownload/hba1c.dta
use hba1c.dta, clear
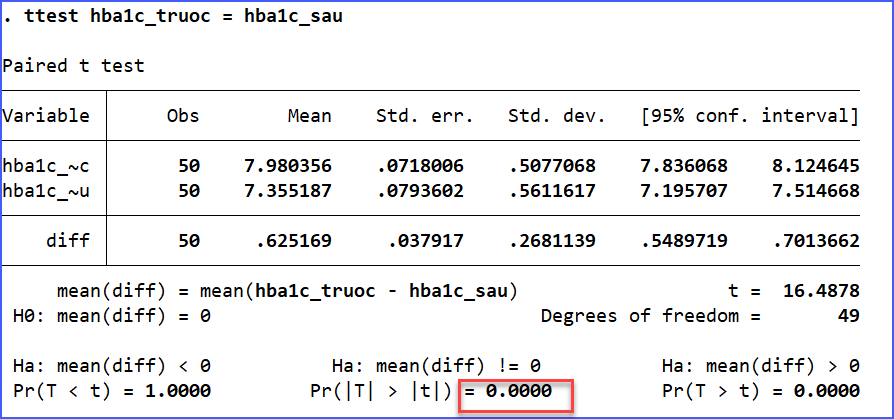
ttest hba1c_truoc = hba1c_sau


Giải thích kết quả lệnh paired sample.
Do trung bình HbA1c sau < trước và p < 0.05, nên kết luận rằng có sự khác biệt về giá trị HbA1c sau và trước, nên suy ra chương trình can thiệp có hiệu quả.

5. Lưu ý khi dùng T-test trong Stata

Giả định về phân phối: T-test giả định dữ liệu phân phối chuẩn. Có thể kiểm định nhanh qua histogram hoặc lệnh sktest.
Kiểm tra động nhất phương sai: Trong T-test hai mẫu, nếu phương sai không đồng nhất, Stata sẽ điều chỉnh tự động (Welch correction).
Biến nhóm phải được mã hóa rõ ràng (0/1 hoặc 1/2).
Tóm lại, T-test là công cụ kiểm định cơ bản,rất hiệu quả trong nghiên cứu y tế. Việc sử dụng đúng loại T-test trong Stata giúc bạn đưa ra những kết luận mang tính khoa học và đáng tin cậy.

Nếu bạn cần hỗ trợ thêm về việc chạy mô hình hoặc xử lý số liệu, đừng ngần ngại liên hệ với nhóm MBA Bách Khoa qua các kênh sau:

-Zalo 0903396688 phone no

-Facebook  facebook.com/hotroStata