Category Archives: Stata

So sánh OLS, GLS và FGLS và cách áp dụng trong Stata

Trong phân tích hồi quy, việc lựa chọn phương pháp ước lượng phù hợp là yếu tố then chốt để đảm bảo kết quả nghiên cứu đáng tin cậy. Ba phương pháp phổ biến là:

  • OLS (Ordinary Least Squares) – Hồi quy tuyến tính thông thường
  • GLS (Generalized Least Squares) – Hồi quy bình phương tối thiểu tổng quát
  • FGLS (Feasible Generalized Least Squares) – GLS khả thi khi không biết chính xác cấu trúc sai số

1. OLS là gì?

OLS là phương pháp hồi quy tuyến tính cổ điển, được sử dụng rộng rãi nhờ sự đơn giản và hiệu quả trong đa số các bài toán cần giải quyết.
Giả định chính của OLS:

  • Phương sai sai số không đổi (homoskedasticity)
  • Không có tự tương quan
  • Không có đa cộng tuyến hoàn hảo

Cách chạy OLS trong Stata:
reg y x1 x2 x3
Ưu điểm:
    Dễ sử dụng, diễn giải rõ ràng
    Ước lượng không chệch (unbiased) nếu các giả định được đảm bảo
Nhược điểm:
    Khi giả định bị vi phạm (ví dụ: phương sai thay đổi), sai số chuẩn sẽ bị sai lệch → kiểm định t và F không còn đáng tin cậy

2. GLS là gì?

GLS là phiên bản tổng quát của OLS, dùng khi biết cấu trúc của phương sai sai số hoặc ma trận hiệp phương sai.
GLS phù hợp khi:
    Có tự tương quan (AR1, MA1…)
    Có phương sai sai số thay đổi (heteroskedasticity)
    Và bạn biết rõ cấu trúc của sai số
Ưu điểm:
    Cho ước lượng BLUE (Best Linear Unbiased Estimator) trong điều kiện vi phạm giả định của OLS
    Hiệu quả hơn OLS nếu áp dụng đúng
Nhược điểm:
    Hiếm khi biết chính xác cấu trúc sai số trong thực tế → ít được áp dụng trực tiếp

3. FGLS là gì?

FGLS (Feasible GLS) là phiên bản thực tế hơn của GLS, khi cấu trúc sai số không biết nhưng có thể ước lượng được từ dữ liệu.
FGLS là lựa chọn tốt trong các nghiên cứu vi phạm giả định phương sai đồng nhất hoặc có tự tương quan.
Cách chạy FGLS trong Stata với dữ liệu bảng (panel):
xtset id time
xtgls y x1 x2 x3, panels(heteroskedastic)

Hoặc nếu có tự tương quan:
xtgls y x1 x2 x3, panels(heteroskedastic) corr(ar1)
Ưu điểm:
    Ứng dụng thực tế cao
    Hiệu quả hơn OLS trong trường hợp vi phạm giả định
    Có thể xử lý đồng thời nhiều vấn đề (phương sai thay đổi + tự tương quan)
Nhược điểm:
    Nhạy cảm với sai số trong ước lượng ma trận hiệp phương sai
    Không luôn tốt hơn OLS trong mẫu nhỏ

4. So sánh tổng quát giữa OLS, GLS và FGLS

Tiêu chí OLS GLS FGLS
Điều kiện áp dụng Giả định cổ điển đúng Biết cấu trúc sai số Cấu trúc sai số không biết nhưng có thể ước lượng
Ước lượng BLUE? Có nếu giả định đúng Có nếu cấu trúc đúng Gần BLUE nếu ước lượng chính xác
Độ phổ biến Rất phổ biến Ít dùng Phổ biến trong phân tích nâng cao
Độ phức tạp Thấp Cao nếu tính tay Trung bình, có thể dùng Stata
Xử lý phương sai thay đổi Không Có Có
Xử lý tự tương quan Không Có Có

5. Khuyến nghị sử dụng theo kinh nghiệm giảng dạy

Là người từng hướng dẫn hàng trăm luận văn và nghiên cứu thực nghiệm, tôi đề xuất quy trình sau để lựa chọn phương pháp:
Bước 1: Bắt đầu với OLS và kiểm định các giả định:
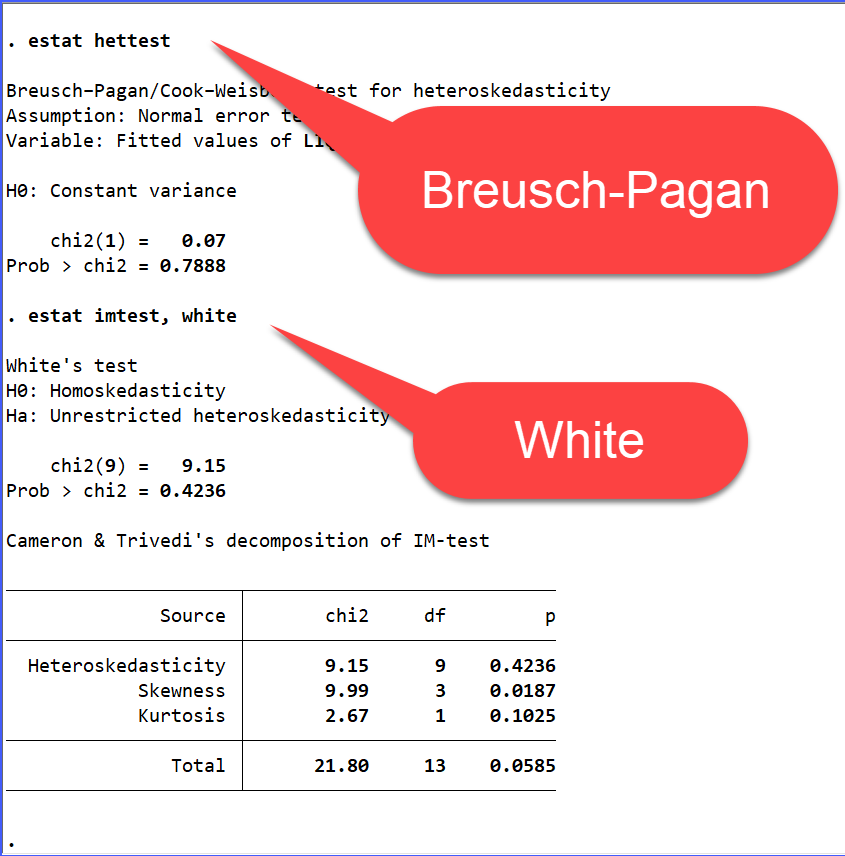
    Kiểm định phương sai thay đổi: estat hettest, estat imtest, white
    Kiểm định tự tương quan (với dữ liệu chuỗi thời gian/bảng): dwstat , xtserial
Bước 2: Nếu vi phạm => chuyển sang sử dụng:
    reg …, robust nếu chỉ có phương sai thay đổi
    xtgls … nếu là dữ liệu bảng hoặc vi phạm phức tạp
Bước 3: Luôn trình bày rõ ràng trong bài nghiên cứu:
    Kết quả kiểm định giả định
    Lý do chọn FGLS hoặc robust SE thay cho OLS

Trong quá trình sử dụng các bạn có cần hỗ trợ cứ liên hệ nhóm theo số phone sau nhé

Phân biệt kiểm định Breusch-Pagan và White trong Stata : lựa chọn nào để phát hiện phương sai thay đổi

1. Khái niệm phương sai sai số thay đổi

Trong hồi quy tuyến tính có một giả định là phương sai của sai số phải không đổi (homoskedasticity). Khi giả định này bị vi phạm – phương sai của phần dư thay đổi theo giá trị của biến độc lập – ta nói rằng mô hình có phương sai sai số thay đổi. lưu ý là SAI SỐ chính là PHẦN DƯ nhé.
Hậu quả: Các ước lượng OLS vẫn không chệch, nhưng sai số chuẩn bị sai lệch, khiến các kiểm định t và F không còn đáng tin cậy.
Để phát hiện vấn đề này trong Stata, hai phương pháp phổ biến nhất là:

  •     Kiểm định Breusch-Pagan (BP Test)
  •     Kiểm định White (White Test)

2. So sánh kiểm định Breusch-Pagan và White

Tiêu chí

Kiểm định Breusch-Pagan

Kiểm định White

Được đề xuất bởi

Breusch & Pagan (1979)

Halbert White (1980)

Giả định

Mối quan hệ tuyến tính giữa sai số và biến độc lập

Cho phép cả tuyến tính và phi tuyến

Độ nhạy với mô hình phi tuyến

Thấp hơn

Cao hơn

Phát hiện tương tác

Không

Có thể phát hiện tương tác giữa biến độc lập

Tính toán

Đơn giản hơn

Phức tạp hơn một chút

Khuyến nghị sử dụng

Mô hình tuyến tính đơn giản

Mô hình có biến tương tác, phi tuyến

3. Khi nào nên dùng Breusch-Pagan?

Ta sử dụng kiểm định Breusch-Pagan khi:

  •     Mô hình của tuyến tính rõ ràng
  •     Không có biến tương tác hay biến đa thức (như x², x³)
  •     Cần một kiểm định nhanh, đơn giản

Ví dụ lệnh trong Stata:
reg y x1 x2 x3
estat hettest

Kết quả trả về:
Breusch-Pagan / Cook-Weisberg test for heteroskedasticity
Ho: Constant variance
chi2(1) = 6.87
Prob > chi2 = 0.0088

Do p-value < 0.05 => Có phương sai thay đổi => Vi phạm giả định OLS

4. Khi nào nên dùng kiểm định White?

White test nên được sử dụng khi:

  •     Mô hình có chứa biến tương tác hoặc biến phi tuyến (log, bình phương, căn bậc hai…)
  •     Kiểm định toàn diện hơn, không giới hạn bởi tuyến tính
  •     Dữ liệu dạng cắt ngang với phân tán sai số không đều

Ví dụ lệnh trong Stata:
reg y x1 x2 x3
estat imtest, white

Kết quả:
White's test for Ho: homoskedasticity
Chi2(9) = 20.45
Prob > chi2 = 0.014

=> p-value < 0.05 => Có bằng chứng về phương sai sai số thay đổi.

5. Ưu và nhược điểm của mỗi kiểm định

-Breusch-Pagan
    Ưu điểm: Tính toán nhanh, trực quan, dễ diễn giải
    Nhược điểm: Không phát hiện được quan hệ phi tuyến hoặc tương tác
-White
    Ưu điểm: Linh hoạt, không yêu cầu tuyến tính, phát hiện được tương tác và phi tuyến
    Nhược điểm: Có thể quá nhạy trong mẫu nhỏ => dễ báo sai

6. Tóm lại

    Là người đã giảng dạy và sử dụng Stata trong hàng trăm dự án nghiên cứu định lượng, Ths Khánh và nhóm khuyến nghị như sau:
    -Mô hình tuyến tính đơn giản nên dùng Breusch-Pagan
    -Mô hình có biến bình phương, log, tương tác nên dùng White
    -Cần đánh giá chắc chắn về heteroskedasticity => thực hiện cả hai kiểm định
    Ngoài ra, nên kết hợp với phân tích đồ họa phần dư (residual plots) để có đánh giá trực quan hơn: rvfplot

7. Xử lý nếu phát hiện phương sai thay đổi

Sau khi kiểm định phát hiện phương sai thay đổi, bạn có thể:

  •     Sử dụng hồi quy với robust standard errors: reg y x1 x2 x3, robust
  •     Dùng phương pháp hồi quy hiệu chỉnh như FGLS (Feasible Generalized Least Squares)
  •     Thử biến đổi mô hình (logarit hóa biến phụ thuộc và/hoặc độc lập)


Kiểm định White trong Stata: Phát hiện phương sai thay đổi đơn giản và hiệu quả

1. Kiểm định White là gì?

     Trong hồi quy tuyến tính cổ điển (Ordinary Least Squares – OLS), một trong những giả định quan trọng là phương sai của sai số phải đồng nhất (homoskedasticity). Khi giả định này bị vi phạm – tức phương sai thay đổi theo giá trị của biến độc lập – ta gặp hiện tượng heteroskedasticity (phương sai sai số thay đổi).
     Kiểm định White, được đề xuất bởi Halbert White (1980), là một phương pháp thống kê dùng để phát hiện phương sai thay đổi trong mô hình hồi quy, không yêu cầu giả định phân phối chuẩn hay tuyến tính giữa phần dư và biến độc lập. Vì vậy, kiểm định này rất linh hoạt và phù hợp với nhiều dạng mô hình, đặc biệt là dữ liệu chéo (cross-section).

2. Tại sao kiểm định phương sai thay đổi lại quan trọng?

     Nếu bạn bỏ qua hiện tượng phương sai thay đổi, bạn vẫn có thể thu được ước lượng hệ số hồi quy đúng (unbiased), nhưng độ lệch chuẩn của hệ số sẽ sai → dẫn đến việc kiểm định t và F không còn đáng tin cậy. Điều này ảnh hưởng trực tiếp đến kết luận nghiên cứu.
     Đặc biệt trong các nghiên cứu định lượng dùng Stata để phân tích dữ liệu kinh tế, xã hội, y tế, hiện tượng này thường xuất hiện do sự đa dạng trong biến quan sát.
     Ví dụ: Khi mô hình hóa thu nhập theo trình độ học vấn, sai số có thể biến động mạnh giữa nhóm học vấn thấp và cao – một trường hợp điển hình của heteroskedasticity.

3. Khi nào nên thực hiện kiểm định White?

Khi dữ liệu của bạn là cross-sectional (dữ liệu cắt ngang- chéo)
Khi bạn nghi ngờ rằng sai số trong mô hình không phân bố đều
Khi biểu đồ phần dư (residual plot) cho thấy dạng hình quạt hoặc bất đối xứng
Khi mô hình có nhiều biến độc lập và tương tác – dễ phát sinh mối quan hệ phi tuyến giữa phần dư và biến độc lập

4. Cách thực hiện kiểm định White trong Stata

Sau khi ước lượng mô hình hồi quy, bạn có thể chạy lệnh sau:
reg y x1 x2 x3
estat imtest, white

Trong đó:
reg là lệnh hồi quy tuyến tính
estat imtest, white thực hiện kiểm định White dựa trên phần dư
Diễn giải kết quả:
Nếu p-value < 0.05, bạn bác bỏ giả thuyết H₀ (phương sai sai số đồng nhất), tức là có bằng chứng về phương sai thay đổi.
Nếu p-value ≥ 0.05, mô hình chưa có dấu hiệu vi phạm giả định phương sai đồng nhất.

5. Ví dụ minh họa kiểm định White trong Stata

Giả sử bạn có bộ dữ liệu nghiên cứu về mức lương (wage) theo kinh nghiệm (exper), trình độ học vấn (educ), và giới tính (gender):
use wage_data.dta, clear
reg wage exper educ gender
estat imtest, white

Kết quả có thể như sau:
White's test for Ho: homoskedasticity
against Ha: unrestricted heteroskedasticity
Chi2(9) = 27.53
Prob > chi2 = 0.0011

→ Vì p-value = 0.0011 < 0.05 → có hiện tượng phương sai thay đổi.

6. Cách xử lý khi phát hiện phương sai thay đổi

Có 3 hướng phổ biến:
a. Dùng sai số chuẩn hiệu chỉnh (robust standard errors)
reg wage exper educ gender, robust
→ Giúp bạn vẫn dùng OLS nhưng có sai số chuẩn đáng tin cậy hơn.
b. Dùng mô hình hồi quy FGLS (nếu dùng data panel)
xtgls y x1 x2 x3, panels(heteroskedastic)
c. Biến đổi mô hình
Dùng logarit biến phụ thuộc để loại bỏ hoặc thay thế biến có ảnh hưởng quá lớn đến phần dư
Lưu ý nhỏ: dù kiểm định White linh hoạt, nhưng vẫn nên kết hợp với phân tích đồ họa phần dư, và kiểm định Breusch-Pagan để có đánh giá toàn diện hơn.

Nếu bạn đang gặp khó khăn trong xử lý dữ liệu và thực hiện phân tích, dịch vụ hỗ trợ từ phantichstata.com có thể giúp bạn tiết kiệm thời gian và đảm bảo kết quả chính xác nhất.

Nếu bạn cần hỗ trợ thêm về việc chạy mô hình hoặc xử lý số liệu, đừng ngần ngại liên hệ với ThS  nhóm MBA Bách Khoa qua các kênh sau:

-Zalo 0903396688 

-Facebook  facebook.com/hotroStata


FGLS trong Stata: Giải pháp cho phương sai sai số thay đổi và tự tương quan

1.Giới thiệu về hồi quy FGLS

Trong phân tích hồi quy, một trong những giả định quan trọng của mô hình hồi quy tuyến tính là phương sai của sai số phải đồng nhất. Tuy nhiên, trong thực tế, hiện tượng phương sai sai số thay đổi thường xảy ra, làm cho các ước lượng không còn hiệu quả. Một phương pháp phổ biến để khắc phục vấn đề này là sử dụng hồi quy FGLS (Feasible Generalized Least Squares).

FGLS là một phương pháp ước lượng giúp cải thiện tính chính xác của hồi quy khi mô hình gặp phải hiện tượng phương sai sai số thay đổi hoặc tự tương quan. Trong bài viết này, chúng ta sẽ đi sâu vào:

  • Khi nào cần sử dụng FGLS?
  • Cách thực hiện FGLS trong Stata
  • Giải thích kết quả FGLS

2. Khi nào nên sử dụng FGLS?

Hồi quy FGLS thích hợp khi:

  • Có hiện tượng phương sai sai số thay đổi : Khi phương sai của sai số không đồng đều giữa các quan sát, các ước lượng trở nên không hiệu quả.
  • Có hiện tượng tự tương quan trong dữ liệu chuỗi thời gian: Khi các sai số có mối quan hệ với nhau qua các thời điểm khác nhau, FGLS có thể giúp cải thiện mô hình.
  • Dữ liệu bảng panel data: Khi có sự khác biệt về phương sai giữa các cá nhân hoặc nhóm, FGLS giúp điều chỉnh sai số hiệu quả hơn.

3. Cách chạy hồi quy FGLS trong Stata

Bước 1: Kiểm tra hiện tượng phương sai sai số thay đổi

Trước khi sử dụng FGLS, cần kiểm tra xem mô hình có bị phương sai sai số thay đổi hay không. Một trong những kiểm định phổ biến là Breusch-Pagan:

Ví dụ mô hình tác động ngẫu nhiên được chọn, ta sẽ kiểm tra phương sai sai số thay đổi bằng "Breusch and Pagan Lagrangian multiplier test for random effects"

xtreg    LIQ SIZE CAP ROE NIM, re
xttest0

Nếu giá trị p-value < 0.05, ta bác bỏ giả thuyết H0 (phương sai sai số đồng nhất) và kết luận rằng có hiện tượng phương sai sai số thay đổi.

Bước 2: Kiểm tra hiện tượng tự tương quan

.  xtserial  LIQ SIZE CAP ROE NIM

Wooldridge test for autocorrelation in panel data
H0: no first-order autocorrelation
    F(  1,      28) =      3.697
           Prob > F =      0.0647

Nếu giá trị p-value Prob < 0.05, ta bác bỏ giả thuyết H0 (không có tự tương quan) và kết luận rằng có hiện tượng tự tương quan

Bước 3: Chạy hồi quy FGLS

Sau khi xác nhận có phương sai sai số thay đổi, chúng ta thực hiện FGLS bằng cách sử dụng lệnh xtgls trong Stata:

xtgls y x1 x2 x3, panels(heteroskedastic)

y là biến phụ thuộc

x1 x2 x3 là các biến độc lập

panels(heteroskedastic) giúp điều chỉnh phương sai sai số thay đổi theo từng cá nhân trong dữ liệu bảng

. xtgls    LIQ SIZE CAP ROE NIM, panels(heteroskedastic)

Cross-sectional time-series FGLS regression

Coefficients:  generalized least squares
Panels:        heteroskedastic
Correlation:   no autocorrelation

Estimated covariances      =        29          Number of obs     =        145
Estimated autocorrelations =         0          Number of groups  =         29
Estimated coefficients     =         5          Time periods      =          5
                                                Wald chi2(4)      =     198.09
                                                Prob > chi2       =     0.0000


Nếu có cả tự tương quan và phương sai sai số thay đổi, ta dùng:

xtgls y x1 x2 x3, panels(heteroskedastic) corr(ar1)

Lệnh trên giả định sai số có cấu trúc tự tương quan bậc 1 (AR(1)).

. xtgls    LIQ SIZE CAP ROE NIM, panels(heteroskedastic) corr(ar1)

Cross-sectional time-series FGLS regression

Coefficients:  generalized least squares
Panels:        heteroskedastic
Correlation:   common AR(1) coefficient for all panels  (0.0498)

Estimated covariances      =        29          Number of obs     =        145
Estimated autocorrelations =         1          Number of groups  =         29
Estimated coefficients     =         5          Time periods      =          5
                                                Wald chi2(4)      =     184.78
                                                Prob > chi2       =     0.0000

4. Giải thích kết quả hồi quy FGLS

Sau khi chạy lệnh xtgls, Stata sẽ hiển thị bảng kết quả. Một số yếu tố quan trọng cần lưu ý:

Hệ số ước lượng (Coef.): Thể hiện mức độ ảnh hưởng của từng biến độc lập lên biến phụ thuộc.

Giá trị p-value: Nếu p-value < 0.05, biến đó có ảnh hưởng đáng kể đến biến phụ thuộc.

5. Kết luận về FGLS trong Stata

Hồi quy FGLS là một phương pháp tốt giúp điều chỉnh phương sai sai số thay đổi và tự tương quan, giúp cải thiện tính chính xác của mô hình hồi quy. Khi dữ liệu của bạn gặp phải vấn đề heteroskedasticity hoặc autocorrelation, sử dụng FGLS là một lựa chọn phù hợp để có được ước lượng đáng tin cậy hơn.

Nếu bạn đang gặp khó khăn trong xử lý dữ liệu và thực hiện phân tích hồi quy FGLS, dịch vụ hỗ trợ từ phantichstata.com có thể giúp bạn tiết kiệm thời gian và đảm bảo kết quả chính xác nhất.

Nếu bạn cần hỗ trợ thêm về việc chạy mô hình hoặc xử lý số liệu, đừng ngần ngại liên hệ với nhóm MBA Bách Khoa qua các kênh sau:

-Zalo 0903396688 

-Facebook  facebook.com/hotroStata


Mô hình tác động ngẫu nhiên Random Effects và cách chạy trong Stata

1. Giới thiệu về mô hình tác động ngẫu nhiên (RE)

Mô hình tác động ngẫu nhiên (Random Effects – RE) là một trong hai mô hình phổ biến được sử dụng trong phân tích dữ liệu bảng (panel data), bên cạnh mô hình tác động cố định (Fixed Effects – FE).

Khi nào sử dụng mô hình Random Effects?

  • Khi các yếu tố không quan sát được không có tương quan với các biến độc lập trong mô hình.
  • Khi muốn khai thác cả sự thay đổi giữa các cá thể và theo thời gian.
  • Khi số lượng cá thể lớn và số lần quan sát ít (N lớn, T nhỏ).
  • Khi muốn đưa vào mô hình các biến không thay đổi theo thời gian (vd: giới tính, địa lý, ngành nghề…).

Ngược lại, nếu các yếu tố không quan sát có tương quan với biến độc lập, mô hình RE sẽ cho ước lượng bị chệch. Khi đó, mô hình Fixed Effects (FE) sẽ phù hợp hơn.

2. Đặc điểm của mô hình Random Effects (RE)

Mô hình RE giả định các yếu tố không quan sát là một biến ngẫu nhiên, không có tương quan với các biến độc lập.

Hồi quy sử dụng phương pháp Generalized Least Squares (GLS) thay vì Ordinary Least Squares (OLS).

3. Cách chạy mô hình Random Effects trong Stata

3.1. Kiểm tra dữ liệu bảng

Trước khi chạy mô hình, cần kiểm tra xem dữ liệu có đúng dạng bảng hay không:

xtset id time

id: Biến định danh cá thể (vd: mã doanh nghiệp, mã quốc gia…).

time: Biến thời gian (vd: năm, quý, tháng…).

Stata sẽ hiển thị thông tin về dữ liệu bảng, bao gồm số cá thể và số giai đoạn thời gian.

3.2. Chạy mô hình Random Effects

Lệnh cơ bản để chạy mô hình tác động ngẫu nhiên trong Stata là:

xtreg y x1 x2 x3, re

y: Biến phụ thuộc.

x1, x2, x3: Các biến độc lập.

re: Tùy chọn để chạy mô hình Random Effects.

3.3. Kiểm định Hausman để lựa chọn giữa FE và RE

Nếu không chắc chắn nên dùng mô hình Fixed Effects (FE) hay Random Effects (RE), ta có thể sử dụng kiểm định Hausman.

hausman fe re

Nếu p-value < 0.05: Bác bỏ mô hình RE, chọn mô hình FE.

Nếu p-value > 0.05: Không có đủ bằng chứng bác bỏ mô hình RE, có thể sử dụng mô hình RE.

Ở đây p=0.7842 nên ta sử dụng mô  hình RE

3.4. Kiểm tra phương sai sai số thay đổi trong mô hình RE

Nếu nghi ngờ có phương sai sai số thay đổi (heteroskedasticity), có thể kiểm tra bằng lệnh:

xttest0

Nếu có phương sai thay đổi, nên sử dụng sai số chuẩn hiệu chỉnh (robust standard errors) để có ước lượng đáng tin cậy:

xtreg y x1 x2 x3, re vce(robust)

Hoặc cách thông dụng hơn là sử dụng GLS để khắc phục

4. Ví dụ minh họa trong Stata

4.1. Dữ liệu giả định

Giả sử chúng ta có dữ liệu về mức lương của nhân viên trong nhiều công ty khác nhau qua nhiều năm.

ID (Nhân viên) Năm Lương ($) Kinh nghiệm Trình độ Giới tính
1 2019 5000 5 Đại học Nam
1 2020 5500 6 Đại học Nam
2 2019 4800 4 Cao đẳng Nữ
2 2020 5200 5 Cao đẳng Nữ

4.2. Chạy mô hình RE trong Stata

xtset ID Nam

xtreg Luong KinhNghiem TrinhDo GioiTinh, re

Giải thích:

xtset ID Nam: Định dạng dữ liệu bảng.

xtreg Luong KinhNghiem TrinhDo GioiTinh, re: Chạy mô hình RE.

Stata sẽ hiển thị kết quả hồi quy, trong đó các hệ số phản ánh tác động trung bình của từng biến lên mức lương.

4.3. Kiểm định Hausman để chọn giữa FE và RE

xtreg Luong KinhNghiem TrinhDo GioiTinh, fe

estimates store fe

xtreg Luong KinhNghiem TrinhDo GioiTinh, re

estimates store re

hausman fe re

Nếu p-value nhỏ hơn 0.05, ta sử dụng mô hình FE. Nếu lớn hơn 0.05, ta có thể sử dụng mô hình RE.

5. Kết luận

Mô hình tác động ngẫu nhiên (RE) phù hợp khi các yếu tố không quan sát không có tương quan với biến độc lập.

RE cho phép ước lượng hiệu quả hơn khi dữ liệu có nhiều cá thể nhưng ít giai đoạn thời gian.

Kiểm định Hausman giúp xác định mô hình nào phù hợp hơn giữa FE và RE.

Khi có phương sai thay đổi, cần dùng sai số chuẩn hiệu chỉnh (vce(robust)) hoặc GLS

Mô hình Random Effects là một công cụ quan trọng trong phân tích dữ liệu bảng, đặc biệt khi nghiên cứu các dữ liệu kinh tế, tài chính, lao động, và nhiều lĩnh vực khác.

Nếu bạn cần tư vấn hoặc hỗ trợ về phân tích dữ liệu bằng Stata, đừng ngần ngại liên hệ với chúng tôi, nhóm MBA Bách Khoa qua các kênh sau:

-Zalo 0903396688 

-Facebook  facebook.com/hotroStata

Phương sai của sai số thay đổi: định nghĩa, cách phát hiện, cách khắc phục bằng Stata

Thạc sĩ Khánh và nhóm MBA Bách Khoa 0903396688 trình bài về khái niệm phương sai sai số thay đổi: định nghĩa, cách phát hiện, cách khắc phục phương sai sai số thay đổi sử dụng phần mềm Stata.

Định nghĩa phương sai của sai số thay đổi

     Một giả thiết quan trọng trong mô hình hồi quy tuyến tính cổ điển là các yếu tố  nhiễu ui (hay còn gọi là phần dư residuals) xuất hiện trong hàm hồi quy tổng thể có phương sai không thay đổi (homoscedasticity,  còn gọi là phương sai có điều kiện không đổi); tức là chúng có cùng phương sai. Nếu giả thiết này không được thỏa mãn thì có sự hiện diện của phương sai thay đổi. Phương sai thay đổi (Heteroscedasticity, còn gọi là phương sai của sai số thay đổi) .

     Cụ thể điều này có nghĩa là các sai số có cùng phương sai tại mọi mức của biến độc lập. Nếu giả thiết này bị vi phạm, tức là phương sai của sai số thay đổi theo giá trị của biến độc lập, hiện tượng này được gọi là phương sai thay đổi (heteroscedasticity).

     Phương sai thay đổi không làm mất đi tính chất không thiên lệch và nhất quán của các ước lượng OLS. Nhưng các ước lượng này không còn có phương sai nhỏ nhất hay là các ước lượng hiệu quả. Tức là chúng không còn là các ước lượng tuyến tính không thiên lệch tốt nhất (BLUE). Khi có phương sai thay đổi, các phương sai của các ước lượng OLS không được tính từ các công thức OLS thông thường. Nhưng nếu ta vẫn sử dụng các công thức OLS thông thường, các kiểm định t và F dựa vào chúng có thể gây ra những kết luận sai lầm.

Cách phát hiện phương sai sai số thay đổi trong Stata

Kiểm định phương sai sai số thay đổi trong mô hình hồi quy tuyến tính đa biến OLS

Có hai cách chính để kiểm định phương sai sai số thay đổi trong Stata,đó là dùng kiểm định White , hoặc dùng kiểm định Breusch-Pagan

Cách 1: Dùng kiểm định White để kiểm tra phương sai thay đổi( White’s test)

Cú pháp lệnh:

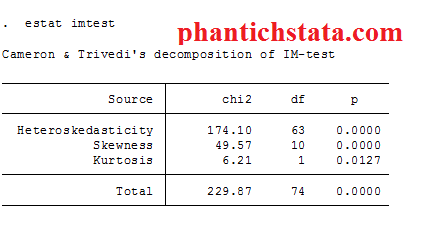
estat imtest

Cách 2: Dùng kiểm định Breusch-Pagan

            estat hettest

Cách đọc kết quả: hai cách trên ,nếu p-value <5% thì,chấp nhận giả thiết H1:Phương sai không đồng nhất, nghĩa là phương sai thay đổi (the variance is not homogenous) ( dĩ nhiên là không tốt, giá trị mong đợi là p.value >5%, lúc đó phương sai đồng nhất, phương sai không đổi).

Kiểm định phương sai sai số thay đổi trong mô hình hồi quy dữ liệu bảng sử dụng fix và random effect

     Phương sai sai số thay đổi heteroskedasticity của mô hình REM: (sử dụng kiểm định LM – Breusch and pagan Lagrangian Multiplier ). Dùng lệnh xttest0, nếu  p-value < 0.05, bác bỏ Ho (với phát biểu  Ho: Phương sai qua các thực thể là không đổi)( làm bài mong đợi p-value >5% để kết luận phương sai ko đổi)

     Phương sai sai số thay đổi heteroskedasticity của mô hình FEM( dùng kiểm định wald): Dùng lệnh xttest3 (lệnh này không có sẵn trong Stata, phải cài thêm bằng lệnh ssc install xttest3) . Nếu  p-value < 0.05, bác bỏ Ho (với phát biểu  Ho: Phương sai qua các thực thể là không đổi)( làm bài mong đợi p-value >5% để kết luận phương sai ko đổi)

Cách khắc phục phương sai thay đổi trong Stata

Khi phát hiện hiện tượng phương sai thay đổi, một phương pháp phổ biến để khắc phục là sử dụng sai số chuẩn hiệu chỉnh (robust standard errors). Phương pháp này giúp điều chỉnh sai số chuẩn của ước lượng, làm cho các kiểm định thống kê trở nên tin cậy hơn ngay cả khi có phương sai thay đổi.

Để thực hiện trong Stata, thêm tùy chọn , robust vào sau lệnh hồi quy. Ví dụ:

regress y x1 x2 x3, robust

Lệnh này sẽ ước lượng mô hình hồi quy của biến phụ thuộc y theo các biến độc lập x1, x2, x3 với sai số chuẩn hiệu chỉnh.

Ngoài ra, trong trường hợp phương sai thay đổi nghiêm trọng, bạn có thể xem xét sử dụng phương pháp hồi quy bình phương tổng quát khả dĩ (Feasible Generalized Least Squares – FGLS). Phương pháp này điều chỉnh mô hình để xử lý phương sai thay đổi và tự tương quan, giúp cải thiện hiệu quả của ước lượng. Tuy nhiên, FGLS yêu cầu giả định về cấu trúc của phương sai thay đổi, do đó cần thận trọng khi áp dụng.

Sử dụng mô hình sai số chuẩn mạnh để khắc phục phương sai sai số thay đổi, cụ thể xem ở đây nhé: https://phantichstata.com/mo-hinh-sai-chuan-manh-robust-standard-errors-la-gi-su-dung-ra-sao.html

Như vậy nhóm MBA Bách Khoa đã giới thiệu tìm hiểu về định nghĩa, cách phát hiện và phương pháp khắc phục hiện tượng phương sai của sai số thay đổi trong mô hình hồi quy sử dụng Stata. Việc nhận diện và xử lý đúng hiện tượng này giúp đảm bảo tính chính xác và tin cậy của các kết luận thống kê trong nghiên cứu.

Nếu bạn cần hỗ trợ thêm về việc chạy mô hình hoặc xử lý số liệu, đừng ngần ngại liên hệ với nhóm MBA Bách Khoa qua các kênh sau:

-Zalo 0903396688 

-Facebook  facebook.com/hotroStata

So sánh Fixed Effects và Random Effects trong dữ liệu bảng – Khi nào nên chọn mô hình nào?

1. Giới thiệu về dữ liệu bảng (Panel Data)

Dữ liệu bảng (panel data) kết hợp dữ liệu chuỗi thời gian và dữ liệu chéo, ghi nhận sự thay đổi theo thời gian của các đối tượng khác nhau. Dữ liệu này thường được sử dụng trong các lĩnh vực như kinh tế, tài chính, xã hội học, và y tế.

So với dữ liệu chéo hoặc chuỗi thời gian đơn thuần, dữ liệu bảng mang lại nhiều lợi ích:

  • Giảm phương sai sai số do có nhiều quan sát hơn.
  • Cho phép kiểm soát tác động cá nhân không quan sát được.
  • Phát hiện các hiệu ứng động như quán tính hoặc tác động trễ của biến số.

2. Mô hình Fixed Effects (FE) và Random Effects (RE)

Mô hình hiệu ứng cố định Fixed Effects (FE)

Khi nào nên sử dụng mô hình hiệu ứng cố định

  • Khi ta nghi ngờ các đặc điểm riêng của đối tượng (đơn vị quan sát) có thể ảnh hưởng đến biến phụ thuộc.
  • Khi ta muốn loại bỏ ảnh hưởng của các đặc điểm bên trong mỗi đối tượng, giúp kiểm soát những yếu tố không thay đổi theo thời gian.
  • Khi dữ liệu có số lượng đối tượng quan sát nhiều và thời gian theo dõi dài.

Mô hình Fixed Effects giúp kiểm soát những đặc điểm không đo lường được của từng cá nhân, từ đó tránh được sự thiên lệch.

Mô hình hiệu ứng ngẫu nhiên Random Effects (RE)

Khi nào nên sử dụng mô hình hiệu ứng ngẫu nhiên

  • Khi các đặc điểm riêng của đối tượng không tương quan với biến độc lập.
  • Khi muốn sử dụng thêm thông tin từ các biến bên trong đối tượng và không muốn mất đi sự biến thiên giữa các cá nhân.
  • Khi dữ liệu có nhiều đối tượng quan sát nhưng số kỳ quan sát ngắn.

Mô hình Random Effects phù hợp khi hiệu ứng cá nhân không liên quan đến các biến độc lập, cho phép ước lượng hiệu quả hơn trong một số trường hợp.

3. Kiểm định Hausman – Cách chọn giữa FE và RE

Để quyết định chọn mô hình FE hay RE, ta sử dụng kiểm định Hausman:

Nếu giá trị p-value < 0.05, ta chọn Fixed Effects.

Nếu giá trị p-value > 0.05, ta chọn Random Effects.

Kiểm định này giúp kiểm tra xem hiệu ứng cá nhân có tương quan với biến độc lập hay không. Nếu có, mô hình RE sẽ cho kết quả thiên lệch và ta cần sử dụng FE.

Cách chạy kiểm định Hausman trong Stata

xtreg Y X, fe

estimates store fixed

xtreg Y X, re

estimates store random

hausman fixed random

Sau khi chạy lệnh trên, Stata sẽ trả về giá trị p-value giúp quyết định mô hình phù hợp.

4. Ví dụ thực tế

Bước 1: Nhập dữ liệu

Giả sử ta có tập dữ liệu về tăng trưởng sản xuất kinh doanh của doanh nghiệp theo thời gian.  https://phantichstata.com/filedownload/0903396688.dta

Tải file này về và sử dụng mở lên như sau

use  0903396688.dta, clear

Bước 2: Chạy mô hình FE

xtreg   PE EG DPO , fe
estimates store fixed

Lệnh này giúp kiểm tra tác động của EG và DPO lên PE bằng mô hình Fixed Effects.

Bước 3: Chạy mô hình RE

xtreg   PE EG DPO , re
estimates store random

Tương tự như trên nhưng sử dụng Random Effects.

Bước 4: Kiểm định Hausman

hausman fixed random

Dựa vào giá trị p-value, ta chọn mô hình phù hợp. Trong ví dụ ở đây giá trị này >5% nên ta chọn mô hình hiệu ứng ngẫu nhiên.

5. Kết luận so sánh Fixed Effects và Random Effects

Bài viết đã giúp bạn hiểu rõ hơn về mô hình Fixed Effects và Random Effects trong dữ liệu bảng. Việc lựa chọn giữa FE và RE phụ thuộc vào mức độ tương quan giữa hiệu ứng cá nhân và biến độc lập. Nếu có sự tương quan, FE sẽ phù hợp hơn; nếu không, RE sẽ cho kết quả tốt hơn do sử dụng hiệu quả thông tin giữa các cá nhân.


Hướng dẫn ứng dụng stata trong nghiên cứu y tế – dành cho bác sĩ, sinh viên ngành y

Trong nghiên cứu y tế, dữ liệu đóng vai trò vô cùng quan trọng. Khi tiến hành một nghiên cứu, bác sĩ, sinh viên ngành Y cần phân tích số liệu từ bệnh nhân, thử nghiệm lâm sàng hoặc khảo sát dịch tễ để đưa ra kết luận chính xác. Do đó Stata trong nghiên cứu y tế cần được lưu ý sử dụng.

Vì sao bác sĩ, sinh viên ngành Y nên học Stata?

Stata là một trong những phần mềm phân tích thống kê mạnh mẽ nhất, giúp các nhà nghiên cứu y học thực hiện:
– Thống kê mô tả để hiểu rõ dữ liệu bệnh nhân.
– Kiểm định giả thuyết để so sánh giữa các nhóm bệnh nhân.
– Hồi quy logistic để tìm hiểu yếu tố nguy cơ gây bệnh.
– Phân tích sống còn để đánh giá thời gian sống của bệnh nhân.

Nếu bạn là bác sĩ, sinh viên ngành Y và chưa quen với Stata, đừng lo! Hãy cùng Thạc Sĩ Khánh và nhóm MBA Bách Khoa HCM tìm hiểu từng bước nhé.

1. Nhập và làm sạch dữ liệu y tế trong Stata

1.1. Nhập dữ liệu từ Excel vào Stata

Bạn có một file Excel chứa dữ liệu bệnh nhân mẫu gồm:

ID (mã bệnh nhân)

Tuổi (age)

Chỉ số BMI (bmi)

Hút thuốc (smoking_status) (1: Có, 0: Không)

Bệnh tim mạch (heart_disease) (1: Có, 0: Không)

Tải excel tại đây:  du_lieu_y_te

Bạn có thể nhập file này vào Stata bằng lệnh:

import excel "C:\Users\admin\Desktop\du_lieu_y_te.xlsx", sheet("Sheet1") firstrow

– Giải thích: Lệnh này sẽ đưa dữ liệu từ Excel vào Stata, với dòng đầu tiên là tiêu đề cột.

1.2. Kiểm tra dữ liệu

Sau khi nhập xong, bạn kiểm tra dữ liệu có bị thiếu hay không bằng cách:

summarize
list if BMI== .

– Giải thích: Lệnh summarize giúp xem tổng quan dữ liệu, còn list if BMI == . sẽ hiển thị bệnh nhân nào bị thiếu giá trị BMI.

1.3. Xử lý dữ liệu bị thiếu

Nếu một số bệnh nhân chưa có BMI, bạn có thể thay thế bằng giá trị trung bình của cả nhóm:

replace BMI= r(mean) if BMI == .

– Giải thích: Lệnh này giúp tự động thay thế BMI bị thiếu bằng giá trị trung bình. Tuy nhiên ở đây 20 quan sát đều đầy đủ nên không cần thực hiện lệnh này, ta vẫn có đầy đủ số liệu

2. Thống kê mô tả và kiểm định giả thuyết

2.1. Xem thống kê tổng quan về bệnh nhân

Nếu bạn muốn xem số lượng bệnh nhân, độ tuổi trung bình, BMI trung bình:

summarize Age BMI

tabulate Smoking_Status

– Giải thích: summarize giúp xem các chỉ số trung bình, độ lệch chuẩn; tabulate hiển thị số lượng người hút thuốc tính theo phần trăm

2.2. So sánh BMI giữa nhóm hút thuốc và không hút thuốc

Bạn muốn biết liệu BMI có khác nhau giữa hai nhóm này hay không? Hãy dùng kiểm định t-test:

ttest BMI, by(Smoking_Status)

– Giải thích: Lệnh này sẽ kiểm tra xem BMI giữa nhóm hút thuốc và không hút thuốc có sự khác biệt đáng kể hay không. Nếu p-value < 0.05, nghĩa là sự khác biệt có ý nghĩa thống kê. Rõ ràng p ở đây là 0.0031 nên ta kết luận có sự khác biệt về BMI giữa nhóm hút thuốc và nhóm không hút thuốc.

3. Hồi quy logistic: Dự đoán nguy cơ mắc bệnh

Bạn muốn biết tuổi, BMI và hút thuốc ảnh hưởng thế nào đến nguy cơ mắc bệnh tim mạch? Hãy sử dụng hồi quy logistic:

logit Heart_Disease Age BMI Smoking_Status

– Giải thích: Lệnh này giúp tính toán nguy cơ mắc bệnh tim mạch dựa trên các yếu tố trên.

Nếu hệ số của smoking_status là dương và có p-value < 0.05, nghĩa là hút thuốc làm tăng nguy cơ mắc bệnh tim mạch một cách đáng kể. Tuy nhiên các giá trị p-value ở đây đều >5% nên ta chưa thể kết luận như vậy được.( do dữ liệu này là bộ dữ liệu testing).

4. Phân tích sống còn: Thời gian sống của bệnh nhân

Nếu bạn muốn nghiên cứu bệnh nhân ung thư sống được bao lâu sau khi điều trị, hãy dùng phân tích sống còn.

4.1. Thiết lập dữ liệu sống còn

Giả sử dữ liệu có cột time (thời gian sống tính theo tháng) và status (1: đã tử vong, 0: vẫn sống). Bạn thiết lập dữ liệu bằng lệnh:

stset Time, failure(Status)

– Giải thích: Lệnh này giúp Stata hiểu rằng bạn đang làm việc với dữ liệu sống còn.

4.2. Vẽ biểu đồ Kaplan-Meier

Bạn muốn xem đường cong sống sót của bệnh nhân:

sts graph

– Giải thích: Biểu đồ Kaplan-Meier sẽ cho bạn thấy bệnh nhân sống sót trong bao lâu sau điều trị.

4.3. Phân tích Cox Regression

Bạn muốn biết yếu tố nào ảnh hưởng đến thời gian sống? Hãy chạy mô hình Cox Regression:

stcox Age BMI Smoking_Status

– Giải thích: Lệnh này giúp xác định yếu tố nào làm giảm hoặc tăng thời gian sống của bệnh nhân.

Kết luận: Vì sao bác sĩ, sinh viên ngành Y nên dùng Stata?

– Nhanh chóng: Xử lý dữ liệu y tế lớn một cách dễ dàng.
– Chính xác: Giúp bạn thực hiện phân tích thống kê và đưa ra kết luận khoa học.
– Trực quan: Cung cấp các biểu đồ giúp bạn trình bày kết quả rõ ràng.

Nếu bạn là bác sĩ, sinh viên ngành Y đang thực hiện nghiên cứu, hãy bắt đầu sử dụng Stata ngay hôm nay.

Trong quá trình sử dụng các bạn có cần hỗ trợ cứ liên hệ nhóm theo số phone sau nhé
 

Hướng dẫn làm sạch dữ liệu trong stata – kỹ thuật xử lý số liệu hiệu quả

Làm sạch dữ liệu là một bước vô cùng quan trọng trong quá trình phân tích dữ liệu bằng Stata. Nếu dữ liệu có lỗi, thiếu giá trị, hay bị nhập sai, kết quả phân tích sẽ không chính xác, ảnh hưởng lớn đến nghiên cứu. Do đó, việc xử lý số liệu, hiệu chỉnh dữ liệu trước khi chạy mô hình là một kỹ thuật cần thiết, giúp nâng cao chất lượng nghiên cứu và đảm bảo các kết luận đưa ra là đáng tin cậy. Trong bài viết này, nhóm MBA Bách Khoa sẽ  cùng bạn tìm hiểu cách làm sạch dữ liệu bằng Stata.

Kiểm tra và xử lý dữ liệu bị thiếu trong stata

Một trong những vấn đề phổ biến nhất khi làm việc với dữ liệu là thiếu giá trị (missing values). Nếu không xử lý cẩn thận, dữ liệu bị thiếu có thể làm sai lệch kết quả phân tích.

Kiểm tra dữ liệu thiếu

Sử dụng lệnh sau để kiểm tra số lượng giá trị bị thiếu:

misstable summarize

Lệnh này giúp bạn xác định những biến nào có dữ liệu bị thiếu và tỷ lệ thiếu là bao nhiêu. Như hình dưới, bài có rất nhiều biến, nhưng chỉ có 2 biến bị thiếu là biến LIQ thiếu 2 và biến SIZE thiếu 1.

Lý do thiếu cụ thể có thể nhìn vào bộ số liệu sau, chỗ dấu  . là đại diện cho missing value theo quy ước của Stata nhé

Xử lý dữ liệu thiếu

Có nhiều cách xử lý dữ liệu bị thiếu trong Stata:

Xóa dòng chứa dữ liệu thiếu: Dùng lệnh drop if missing(varname), nhưng cách này có thể làm mất nhiều dữ liệu quan trọng.

Điền giá trị thay thế: Sử dụng trung bình (replace varname = mean(varname) if missing(varname)) hoặc các phương pháp nội suy khác để thay thế giá trị thiếu.

Phát hiện và xử lý dữ liệu ngoại lai (outliers)

Dữ liệu ngoại lai (outliers) có thể gây ra sai lệch nghiêm trọng trong mô hình phân tích.

Kiểm tra outliers

Một cách phổ biến để tìm kiếm outliers là sử dụng biểu đồ boxplot hoặc thống kê tóm tắt:

summarize varname, detail

Nếu khoảng cách giữa giá trị trung vị (median) và giá trị tối thiểu/tối đa quá lớn, có thể có dữ liệu ngoại lai.

Xử lý outliers

Xóa bỏ outliers: Nếu dữ liệu ngoại lai là do lỗi nhập liệu, có thể xóa chúng bằng drop if varname > ngưỡng.

Biến đổi dữ liệu: Sử dụng log để giảm ảnh hưởng của outliers.

Đánh dấu và kiểm tra: Sử dụng lệnh gen outlier_flag = (varname > ngưỡng) để xem có bao nhiêu giá trị nằm ngoài ngưỡng mong muốn.

Kiểm tra và chuẩn hóa dữ liệu trong stata

Dữ liệu không được chuẩn hóa có thể ảnh hưởng đến phân tích hồi quy và thống kê.

Chuyển đổi dữ liệu định tính thành số

Khi làm việc với dữ liệu định tính, bạn cần mã hóa chúng thành dữ liệu số bằng encode hoặc generate:

encode Biến_String, generate(Biến_ĐịnhLượng)

Điều này giúp bạn dễ dàng sử dụng các biến danh mục trong mô hình phân tích. Đặc biệt là khi bạn dùng lệnh xtset để gán dữ liệu panel, và tên của đối tượng đang là chữ( ví dụ tên của ngân hàng là ACB, Vietcombank…) thì bạn phải dùng cặp lệnh sau

encode Bank, gen( FIRM_CODE)
xtset FIRM_CODE Year

Loại bỏ dữ liệu trùng lặp trong stata

Dữ liệu bị trùng lặp có thể gây ảnh hưởng đến kết quả phân tích và làm sai lệch mô hình thống kê.

Kiểm tra dữ liệu trùng

Bạn có thể sử dụng lệnh sau để kiểm tra các dòng dữ liệu trùng lặp:

duplicates report

Nếu có dữ liệu trùng, cần xử lý ngay để đảm bảo tính chính xác của nghiên cứu.

Xóa dữ liệu trùng lặp

Dùng lệnh sau để xóa các dòng bị trùng

duplicates drop varname, force

Lưu ý chỗ tên biến, bạn phải đưa tất cả các tên biến vào, vì nếu chỉ đưa 1 tên biến thì chương trình sẽ xóa rất nhiều dòng, mà trong khi những dòng đó giá trị chỉ giống nhau giá ở mỗi 1 biến , ví dụ

Thì lệnh bên dưới xóa tận 77 dòng có giá trị LIQ bằng nhau.

Nếu dữ liệu trùng lặp do lỗi nhập liệu, bạn có thể sửa hoặc điền giá trị đúng trước khi xóa.

Tóm lại

Làm sạch dữ liệu là một bước quan trọng để đảm bảo kết quả phân tích đáng tin cậy. Trong bài viết này, chúng ta đã tìm hiểu cách xử lý số liệu trong Stata bao gồm:

✅ Kiểm tra và xử lý dữ liệu bị thiếu. 

✅ Phát hiện và loại bỏ dữ liệu ngoại lai. 

✅ Chuẩn hóa dữ liệu và chuyển đổi biến danh mục. 

✅ Loại bỏ dữ liệu trùng lặp.

Nếu bạn đang gặp khó khăn trong việc xử lý số liệu, hãy liên hệ với nhóm MBA Bách Khoa để nhận hỗ trợ chuyên sâu theo số phone sau nhé

10 bí quyết giúp bạn thành thạo stata nhanh chóng

Stata là một trong những phần mềm thống kê mạnh mẽ nhất, được sử dụng rộng rãi trong nghiên cứu khoa học, kinh tế và xã hội. Tuy nhiên, nếu bạn mới làm quen với Stata, có thể bạn sẽ cảm thấy nó khá phức tạp. Nhóm MBA Bách Khoa chia sẻ 10 bí quyết giúp bạn sử dụng thành thạo Stata hiệu quả hơn, tiết kiệm thời gian và tránh các lỗi thường gặp.

1. Hiểu rõ các kiểu dữ liệu trong stata

Stata làm việc với nhiều kiểu dữ liệu khác nhau như số, chuỗi, ngày tháng và biến phân loại. Việc hiểu rõ các loại dữ liệu này sẽ giúp bạn tránh được các lỗi khi nhập và xử lý dữ liệu. Hãy sử dụng lệnh describe để kiểm tra loại dữ liệu của từng biến trong tập dữ liệu của bạn.

2. Tận dụng do-file để lưu trữ mã lệnh

Thay vì gõ từng lệnh trong cửa sổ lệnh (Command Window), bạn nên viết mã lệnh vào do-file để có thể lưu lại và chạy lại khi cần thiết. Điều này giúp bạn làm việc khoa học hơn và dễ dàng chia sẻ với đồng nghiệp hoặc tái sử dụng trong tương lai.

3. Sử dụng các lệnh quản lý dữ liệu hiệu quả

Stata cung cấp nhiều lệnh để thao tác với dữ liệu, nhưng ba lệnh quan trọng nhất bạn nên biết là:

generate – Tạo biến mới.

replace – Thay đổi giá trị của biến đã có.

egen – Tạo biến tổng hợp một cách linh hoạt hơn.

Ví dụ, nếu bạn muốn tạo một biến thể hiện tổng số điểm từ ba biến điểm thành phần, bạn có thể dùng:

generate total_score = score1 + score2 + score3

4. Sử dụng vòng lặp để tự động hóa công việc

Thay vì lặp lại cùng một lệnh nhiều lần, bạn có thể sử dụng vòng lặp foreach hoặc forvalues để tự động hóa quy trình. Ví dụ:

foreach var in score1 score2 score3 {

    replace `var' = . if `var' < 0 

}

Lệnh trên sẽ kiểm tra tất cả các biến score1, score2, score3 và đặt giá trị thành missing nếu giá trị nhỏ hơn 0.

5. Kiểm tra dữ liệu trước khi phân tích

Trước khi thực hiện bất kỳ phân tích nào, bạn nên kiểm tra dữ liệu bằng các lệnh như:

summarize – Tóm tắt dữ liệu.

list – Xem dữ liệu chi tiết.

tabulate – Kiểm tra tần suất của biến phân loại. Điều này giúp bạn phát hiện các giá trị thiếu, lỗi nhập liệu hoặc phân phối dữ liệu bất thường.

6. Trực quan hóa dữ liệu với các biểu đồ

Biểu đồ giúp bạn hiểu dữ liệu tốt hơn. Stata hỗ trợ nhiều loại biểu đồ như:

Histogram:

graph twoway histogram score1

Scatter Plot:

graph twoway scatter score1 score2

Box Plot:

graph box score1, over(group)

Hãy thử nghiệm các biểu đồ khác nhau để tìm ra cách trình bày dữ liệu phù hợp nhất.

7. Hiểu rõ cách thực hiện hồi quy trong stata

Phân tích hồi quy là một phần quan trọng trong Stata. Để chạy một mô hình hồi quy tuyến tính đơn giản, bạn có thể sử dụng lệnh:

regress y x1 x2 x3

Sau khi chạy lệnh này, bạn cần kiểm tra các giả định của mô hình, chẳng hạn như:

Kiểm tra đa cộng tuyến bằng vif.

Kiểm tra phần dư bằng biểu đồ rvfplot.

8. Xử lý dữ liệu thiếu

Dữ liệu thiếu là vấn đề phổ biến trong phân tích dữ liệu. Bạn có thể kiểm tra giá trị thiếu bằng:

misstable summarize

Nếu bạn muốn thay thế dữ liệu thiếu bằng giá trị trung bình, bạn có thể dùng:

replace var = mean(var) if missing(var)

Tuy nhiên, cần cân nhắc kỹ lưỡng trước khi xử lý dữ liệu thiếu, vì nó có thể ảnh hưởng đến kết quả phân tích.

9. Tối ưu hóa hiệu suất làm việc  

Khi làm việc với dữ liệu lớn, Stata có một số lệnh giúp tăng hiệu suất:

collapse – Tóm tắt dữ liệu để giảm kích thước tập dữ liệu.

compress – Nén dữ liệu để tiết kiệm bộ nhớ.

sort và bysort – Sắp xếp dữ liệu để tăng tốc độ xử lý.

Ví dụ, để tính điểm trung bình theo nhóm, bạn có thể sử dụng:

collapse (mean) score1, by(group)

10. Tận dụng cộng đồng mạng và tài liệu hỗ trợ

Cuối cùng, nếu gặp khó khăn khi sử dụng Stata, bạn có thể tìm kiếm sự trợ giúp từ:

Tài liệu chính thức: help command_name

Cộng đồng Stata: Các diễn đàn như Statalist.org.

Khóa học và hướng dẫn: Các trang web như phantichstata.com cung cấp nhiều tài liệu hữu ích.

Kết luận

Bằng cách áp dụng những bí quyết trên, bạn sẽ làm chủ Stata nhanh chóng và tăng hiệu quả phân tích dữ liệu của mình.
Trong quá trình sử dụng các bạn có cần hỗ trợ cứ liên hệ nhóm theo số phone sau nhé