Với luận văn dùng dữ liệu bảng, chương 4 không chỉ là đọc một bảng hồi quy. Hội đồng muốn thấy chuỗi lập luận chọn mô hình: vì sao chọn FE thay vì RE, mô hình có khuyết tật gì, và bạn khắc phục ra sao. Bài này hướng dẫn viết chương 4 theo đúng thứ tự đó, kèm lệnh Stata, cách xuất bảng và mẫu câu diễn giải.
Quy trình 8 bước của chương 4 (dữ liệu bảng)
- Thống kê mô tả và ma trận tương quan
- Chạy mô hình Pooled OLS, Fixed Effects (FE), Random Effects (RE)
- Lựa chọn mô hình: kiểm định F, Breusch-Pagan LM, Hausman
- Kiểm tra đa cộng tuyến
- Kiểm tra phương sai sai số thay đổi
- Kiểm tra tự tương quan
- Khắc phục bằng FGLS (hoặc sai số chuẩn vững)
- Bảng kết quả cuối cùng, diễn giải và thảo luận
Trong bài, ví dụ dùng biến phụ thuộc roa, các biến độc lập size, lev, growth, biến định danh doanh nghiệp id và biến thời gian year. Bạn thay bằng biến của mình.
Bước 1. Thống kê mô tả và ma trận tương quan
Khai báo dữ liệu bảng trước khi làm bất cứ thứ gì:
xtset id year
. xtset id year
Panel variable: id (strongly balanced)
Time variable: year, 2015 to 2024
Delta: 1 unit
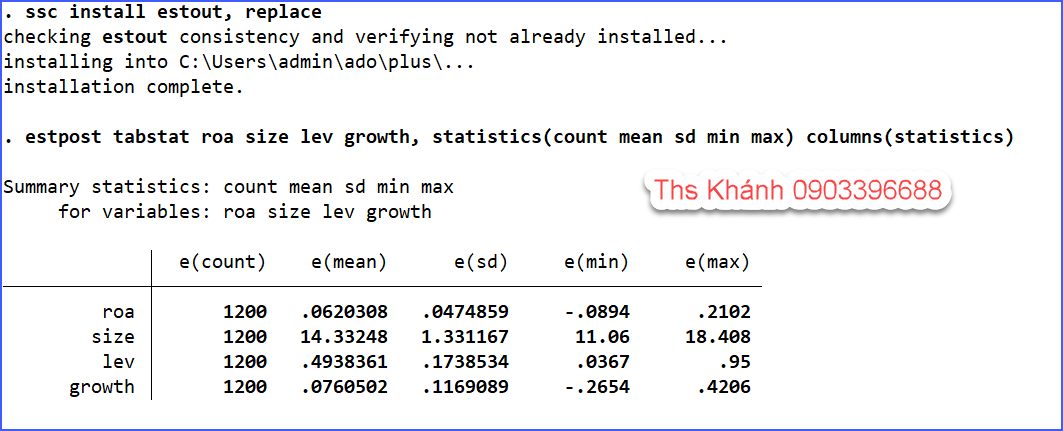
Xuất bảng thống kê mô tả:
ssc install estout, replace
estpost tabstat roa size lev growth, statistics(count mean sd min max) columns(statistics)
esttab using thongke.rtf, cells("count mean(fmt(3)) sd(fmt(3)) min(fmt(3)) max(fmt(3))") noobs nomtitle nonumber replace
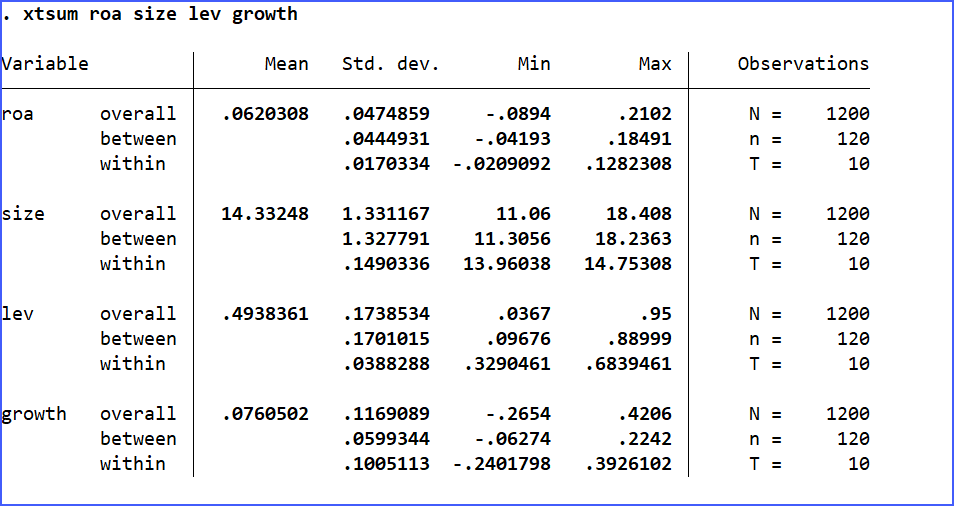
Với dữ liệu bảng, có thể dùng thêm lệnh xtsum để tách độ biến thiên giữa các đơn vị (between) và theo thời gian (within):
xtsum roa size lev growth
Ma trận tương quan:
pwcorr roa size lev growth, star(0.05) sig
Cách diễn giải: nêu giá trị trung bình, độ phân tán, giá trị min/max bất thường, số quan sát và số đơn vị (N, T). Với tương quan, chỉ ra chiều và độ mạnh sơ bộ, nhắc rằng tương quan chưa phải nhân quả.
Mẫu câu: "Bảng 4.1 cho thấy mẫu gồm 1.200 quan sát của 120 doanh nghiệp trong giai đoạn 2015–2024. ROA có giá trị trung bình 0,062, độ lệch chuẩn 0,048, giá trị nhỏ nhất -0,15 và lớn nhất 0,31, cho thấy hiệu quả hoạt động chênh lệch đáng kể giữa các doanh nghiệp."
Nếu gặp lỗi unbalanced khi xtset, xem bài Dữ liệu bảng bị lỗi unbalanced panel khi dùng lệnh xtset.
Bước 2. Chạy mô hình Pooled OLS, FE và RE
Chạy ba mô hình và lưu kết quả để so sánh:
regress roa size lev growth
estimates store pooled
xtreg roa size lev growth, fe
estimates store fe
xtreg roa size lev growth, re
estimates store re
Ở bước này chưa vội diễn giải hệ số. Việc cần làm là cho hội đồng thấy bạn đã ước lượng cả ba mô hình và sẽ chọn mô hình phù hợp ở bước 3. Xem thêm bài Mô hình tác động cố định Fixed effects và các kiểm định liên quan và Mô hình tác động ngẫu nhiên Random Effects và cách chạy trong Stata.
Bước 3. Lựa chọn mô hình: F test, Breusch-Pagan LM, Hausman
Quy trình chọn mô hình gồm ba kiểm định:
|
Kiểm định |
So sánh |
Lệnh |
H0 |
|---|---|---|---|
|
F test (cuối bảng xtreg, fe) |
FE và Pooled OLS |
Tự xuất hiện khi chạy xtreg, fe |
Các hiệu ứng đơn vị đều bằng 0 (Pooled phù hợp) |
|
Breusch-Pagan LM |
RE và Pooled OLS |
xttest0 (chạy ngay sau xtreg, re) |
Phương sai hiệu ứng đơn vị bằng 0 (Pooled phù hợp) |
|
Hausman |
FE và RE |
hausman fe re |
RE phù hợp (không có tương quan giữa hiệu ứng riêng và biến giải thích) |
xtreg roa size lev growth, re
xttest0
hausman fe re
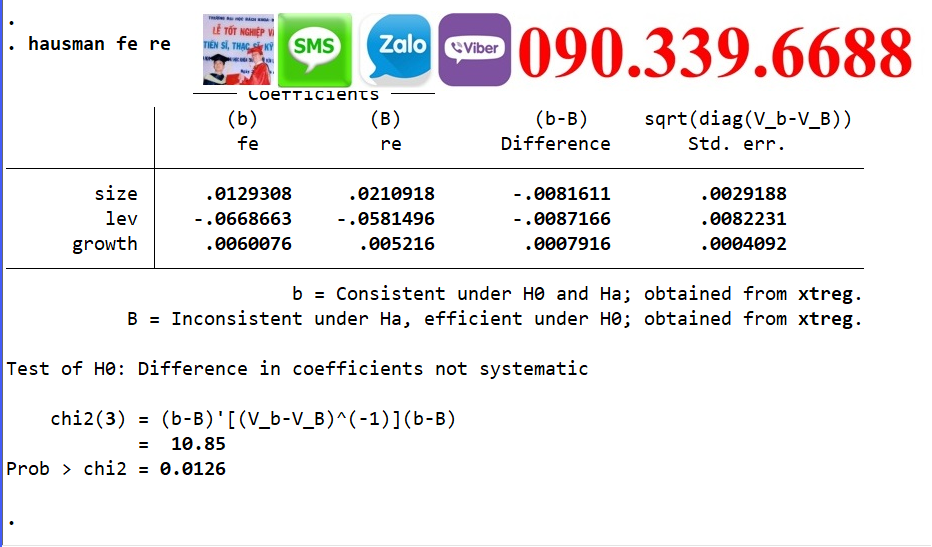
Nếu Hausman cho chi2 âm, xem bài Xử lý lỗi chi2 nhỏ hơn 0 khi kiểm định Hausman. Cách dùng chi tiết có trong bài Cách chạy kiểm định Hausman để lựa chọn giữa mô hình FE và RE.
Mẫu câu: "Kiểm định F ở cuối bảng ước lượng FE có Prob > F = 0,000 < 0,05, bác bỏ H0, do đó FE phù hợp hơn Pooled OLS. Kiểm định Breusch-Pagan LM cho Prob > chibar2 = 0,000 < 0,05, do đó RE phù hợp hơn Pooled OLS. Kiểm định Hausman cho Prob > chi2 = 0,003 < 0,05, bác bỏ H0, vì vậy mô hình tác động cố định (FE) được lựa chọn."
Bước 4. Kiểm tra đa cộng tuyến
Lệnh estat vif chỉ chạy sau regress, nên ta chạy hồi quy OLS thông thường chỉ để tính VIF (đa cộng tuyến là tính chất của các biến độc lập, không phụ thuộc vào FE hay RE):
regress roa size lev growth
estat vif
Quy ước thường dùng: VIF < 10 là chấp nhận được, chặt hơn là VIF < 5. Xem bài Đa cộng tuyến trong Stata: cách dùng lệnh vif.
Mẫu câu: "Bảng 4.4 cho thấy hệ số VIF của các biến đều nhỏ hơn 2 (VIF trung bình là 1,35), thấp hơn ngưỡng 10, do đó mô hình không có hiện tượng đa cộng tuyến nghiêm trọng."
Bước 5. Kiểm tra phương sai sai số thay đổi
Với mô hình FE, dùng kiểm định Modified Wald (cần cài lệnh xttest3):
ssc install xttest3
xtreg roa size lev growth, fe
xttest3
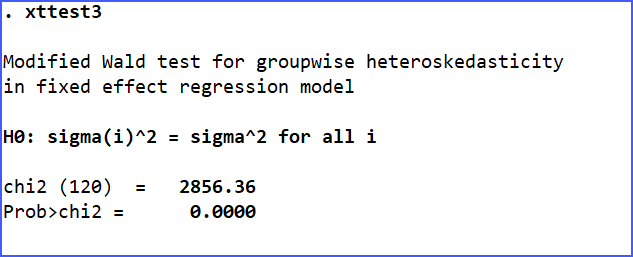
H0: phương sai sai số không đổi giữa các đơn vị. Xem thêm bài Cách cài đặt lệnh xttest3 và Phương sai của sai số thay đổi: định nghĩa, cách phát hiện, cách khắc phục.
Mẫu câu: "Kiểm định Modified Wald có Prob > chi2 = 0,000 < 0,05, bác bỏ H0, cho thấy mô hình FE có hiện tượng phương sai sai số thay đổi."
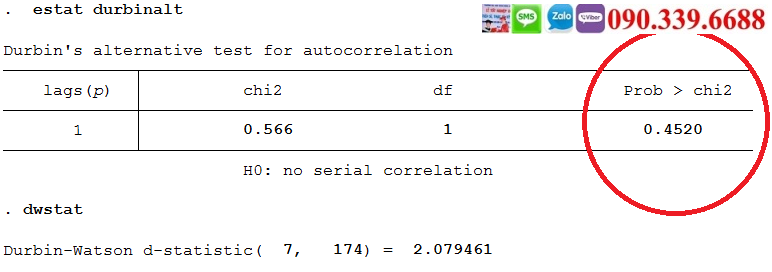
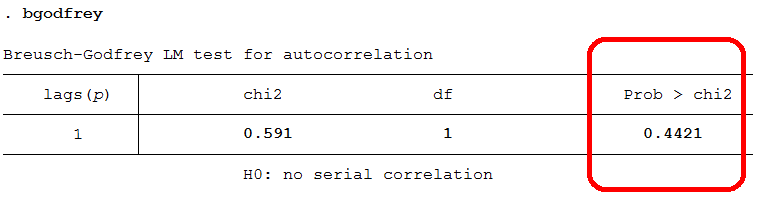
Bước 6. Kiểm tra tự tương quan
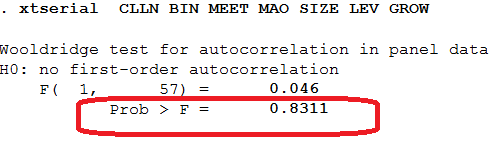
Dùng kiểm định Wooldridge (cần cài lệnh xtserial):
ssc install xtserial
xtserial roa size lev growth
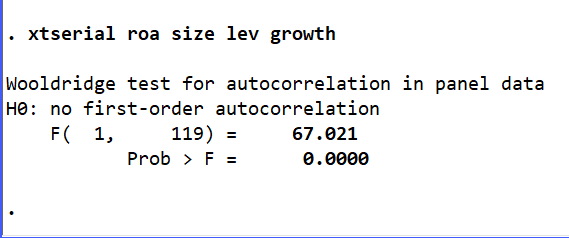
H0: không có tự tương quan bậc 1. Xem thêm bài Cách cài đặt lệnh xtserial và Kiểm định tự tương quan, tương quan chuỗi trong Stata.
Mẫu câu: "Kiểm định Wooldridge có Prob > F = 0,001 < 0,05, bác bỏ H0, cho thấy mô hình có hiện tượng tự tương quan bậc 1."
Bước 7. Khắc phục bằng FGLS
Khi mô hình đồng thời có phương sai thay đổi và tự tương quan, ước lượng FE/RE thông thường cho sai số chuẩn không đáng tin. Hai hướng xử lý phổ biến:
Hướng 1: FGLS
xtgls roa size lev growth, panels(hetero) corr(ar1)
estimates store fgls
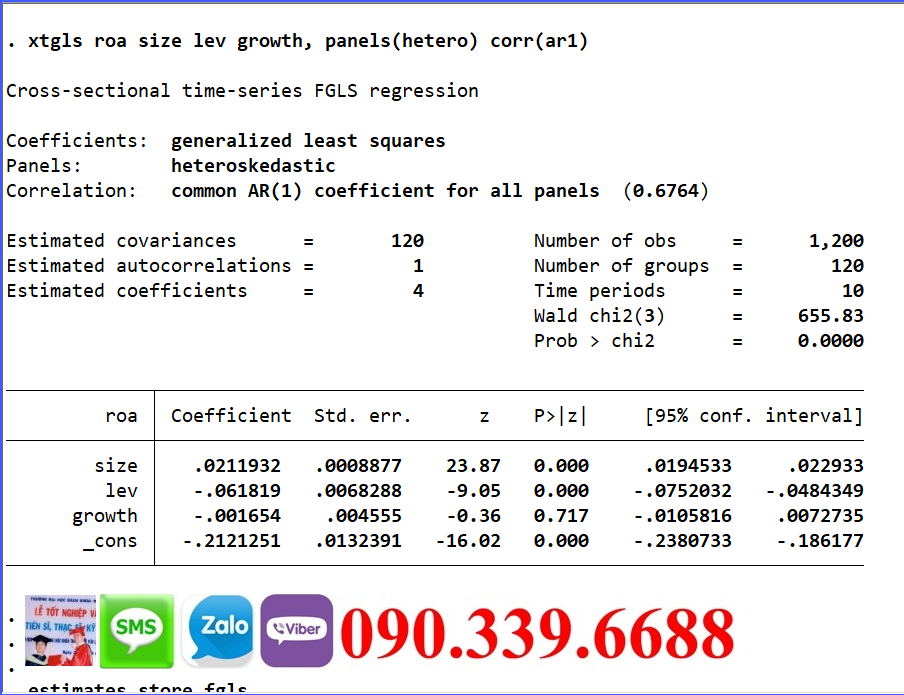
- panels(hetero): cho phép phương sai khác nhau giữa các đơn vị
- corr(ar1): xử lý tự tương quan bậc 1
Hướng 2: giữ FE nhưng dùng sai số chuẩn vững theo cụm
xtreg roa size lev growth, fe vce(cluster id)
estimates store fe_robust
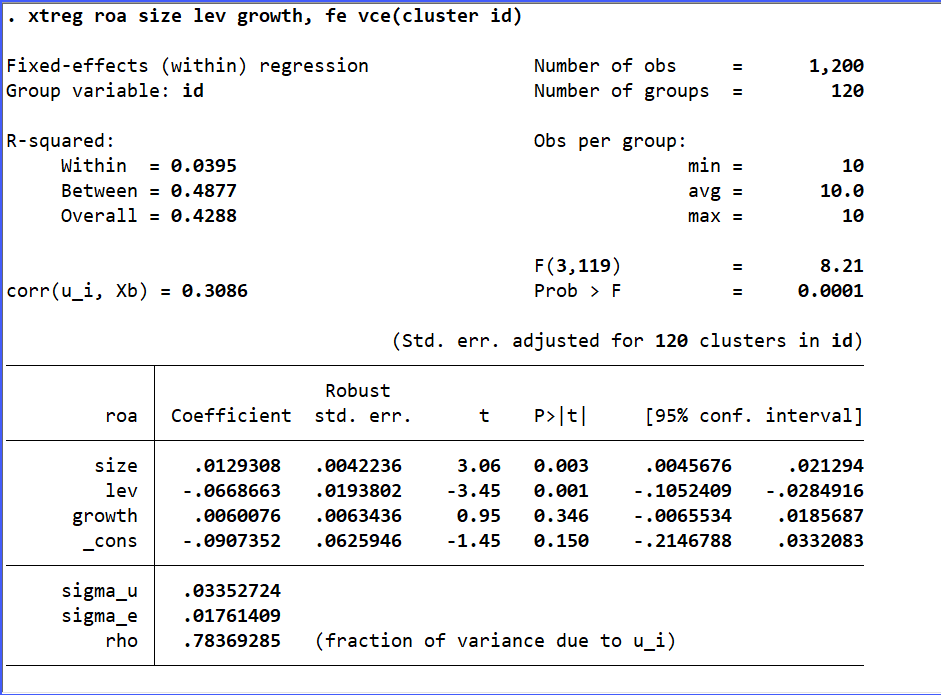
Hai lưu ý quan trọng khi dùng FGLS: (1) tùy chọn panels(correlated) chỉ dùng được khi số kỳ T lớn hơn số đơn vị N, (2) xtgls không tự khử hiệu ứng cố định như xtreg, fe. Chi tiết xem các bài FGLS trong Stata: Giải pháp cho phương sai sai số thay đổi và tự tương quan, So sánh OLS, GLS và FGLS và Khi nào KHÔNG được dùng FGLS trong Stata. Nếu bạn không chắc FGLS phù hợp, dùng vce(cluster id) là lựa chọn an toàn hơn cho mẫu có N lớn, T nhỏ.
Mẫu câu: "Do mô hình FE đồng thời vi phạm giả định về phương sai sai số không đổi và không tự tương quan, nghiên cứu sử dụng phương pháp bình phương tối thiểu tổng quát khả thi (FGLS) để khắc phục. Kết quả FGLS được sử dụng để kiểm định các giả thuyết nghiên cứu."
Bước 8. Bảng kết quả cuối cùng và diễn giải
Đặt các mô hình cạnh nhau để hội đồng dễ so sánh và thấy kết quả bền vững:
esttab pooled fe re fgls , b(3) se(3) star(* 0.10 ** 0.05 *** 0.01) stats(N r2) mtitles("Pooled OLS" "FE" "RE" "FGLS") replace
Lưu ý: xtgls không xuất R-squared, ô này sẽ để trống, bạn ghi chú dưới bảng. Xem thêm bài Lệnh esttab.
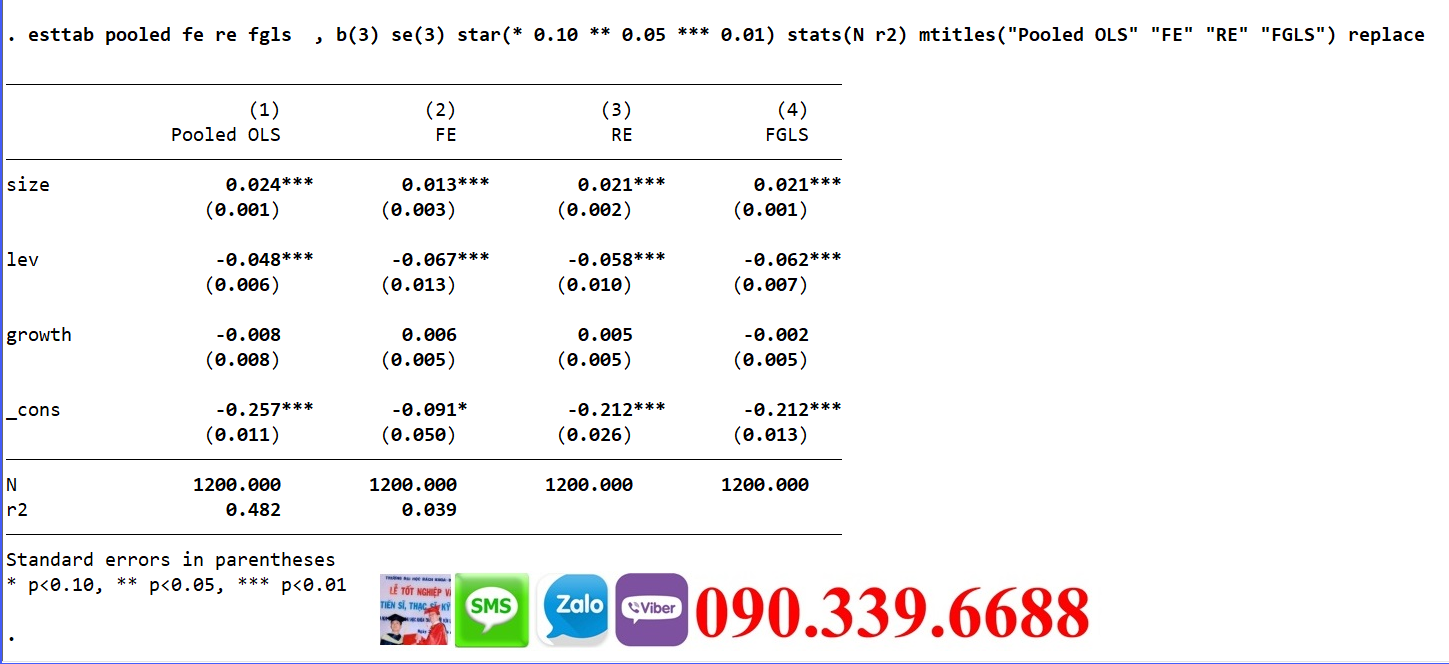
5 điều cần nêu khi diễn giải mô hình cuối (FGLS)
- Chất lượng mô hình: Wald chi2 và p-value (mô hình có ý nghĩa tổng thể)
- Dấu của hệ số: cùng chiều hay ngược chiều giả thuyết
- Ý nghĩa thống kê: p-value hoặc số dấu sao
- Độ lớn tác động: "khi X tăng 1 đơn vị thì Y thay đổi b đơn vị, các yếu tố khác không đổi"
- Kết luận giả thuyết: ủng hộ hay không ủng hộ
Mẫu câu (biến có ý nghĩa): "Kết quả FGLS ở Bảng 4.7 cho thấy SIZE có hệ số 0,014 và có ý nghĩa thống kê ở mức 1% (p < 0,01). Khi quy mô doanh nghiệp tăng 1 đơn vị, ROA tăng trung bình 0,014 đơn vị, các yếu tố khác không đổi. Giả thuyết H1 được ủng hộ."
Mẫu câu (biến không có ý nghĩa): "Biến GROWTH có p-value = 0,27 > 0,05, do đó chưa đủ bằng chứng thống kê để kết luận biến này tác động đến ROA. Giả thuyết H3 không được ủng hộ."
Nên dùng cụm "chưa đủ bằng chứng thống kê" thay vì khẳng định "không có tác động". Nên nhắc thêm rằng kết quả FE với sai số vững và FGLS cùng dấu, cùng mức ý nghĩa (nếu đúng như vậy), vì đó là bằng chứng kết quả bền vững.
Thảo luận kết quả
Với mỗi biến chính, viết đủ ba ý: (1) kết quả của bạn, (2) so sánh với nghiên cứu trước, có trích dẫn tác giả cụ thể, (3) giải thích theo lý thuyết nền hoặc bối cảnh (ngành, quốc gia, giai đoạn).
Mẫu câu khi kết quả khác nghiên cứu trước: "Kết quả này trái với phát hiện của Nguyen (2019), có thể do khác biệt về giai đoạn nghiên cứu và đặc thù ngành trong mẫu của luận văn."
Lỗi thường gặp trong chương 4 dữ liệu bảng
- Chỉ trình bày một mô hình mà không nói vì sao chọn FE/RE (thiếu F test, LM, Hausman)
- Phát hiện khuyết tật nhưng không khắc phục, vẫn diễn giải kết quả FE gốc
- Chạy FGLS mà không nêu lý do hoặc dùng panels(correlated) khi T nhỏ hơn N
- Dán nguyên output Stata thay vì trình bày lại thành bảng có số thứ tự, tiêu đề, nguồn
- Chỉ đọc số mà không diễn giải ý nghĩa kinh tế, quản trị
- Kết luận không khớp giả thuyết nhưng không giải thích
- Làm tròn số không đồng nhất giữa các bảng
Checklist trước khi nộp
☐ Có ghi rõ N (số đơn vị), T (số kỳ), tổng số quan sát, dữ liệu cân bằng hay không cân bằng
☐ Có F test, LM test, Hausman trước khi chọn mô hình
☐ Có kiểm định đa cộng tuyến, phương sai thay đổi, tự tương quan, kèm H0 và p-value
☐ Nêu rõ cách khắc phục (FGLS hoặc sai số chuẩn vững) và lý do chọn
☐ Mỗi bảng có số thứ tự, tiêu đề, nguồn và đoạn nhận xét bên dưới
☐ Kết luận từng giả thuyết rõ ràng, có so sánh với ít nhất 2 nghiên cứu trước
☐ Số liệu trong bài khớp với bảng và file Stata gốc
Nếu bạn cần hỗ trợ xử lý số liệu, chạy hồi quy hoặc kiểm định trên Stata cho luận văn, liên hệ thạc sĩ Khánh và nhóm hỗ trợ Stata qua Zalo 0903396688 hoặc email hotrostata@gmail.com.