1. Thế nào là một kết quả hồi quy "đẹp"?
Khi chạy hồi quy trong Stata, ta thường lo lắng khi nhìn vào bảng kết quả và thấy "không giống trong sách" hay "khác với các nghiên cứu trước". Vậy một kết quả hồi quy được xem là "đẹp" cần đáp ứng những tiêu chí nào?
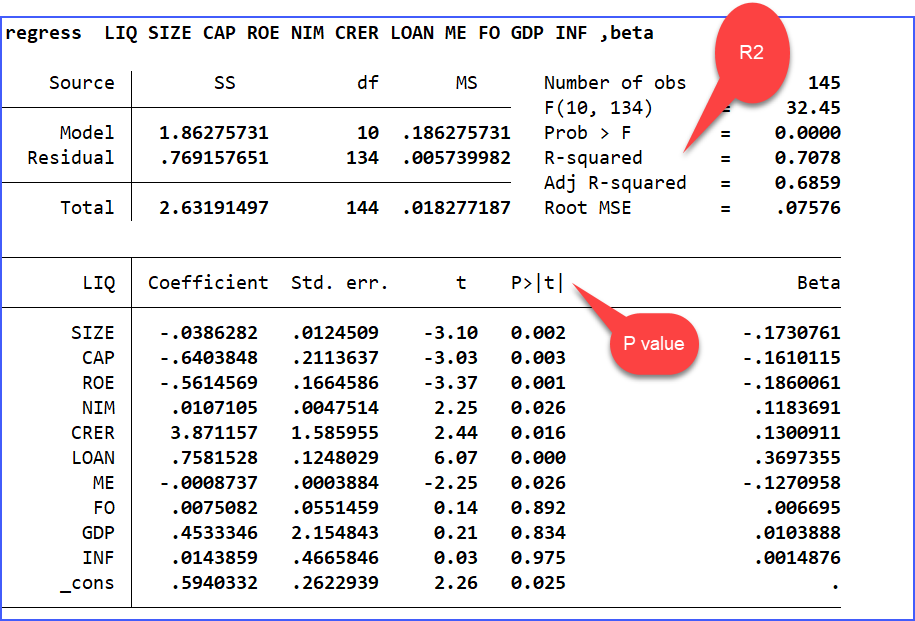

- P-value của biến độc lập quan trọng < 5% (hoặc ít nhất < 10% với một số ngành khoa học xã hội): cho thấy biến đó có ý nghĩa thống kê trong việc giải thích biến phụ thuộc.
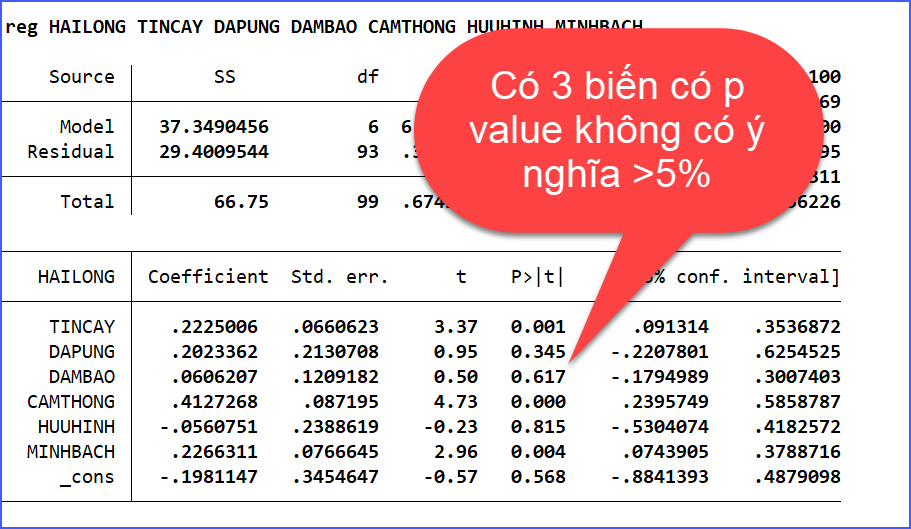

- R² hoặc R² hiệu chỉnh ở mức chấp nhận được: mức "chấp nhận được" phụ thuộc vào loại dữ liệu. Với dữ liệu chuỗi thời gian hoặc dữ liệu bảng vĩ mô, R² có thể trên 0.7–0.8. Nhưng với dữ liệu chéo (cross-section) quy mô lớn, đặc biệt trong các nghiên cứu hành vi, khảo sát cá nhân, R² chỉ 0.2–0.3 vẫn hoàn toàn bình thường và được chấp nhận trong các tạp chí uy tín.
- Dấu hệ số hồi quy đúng với kỳ vọng lý thuyết: ví dụ biến "trình độ học vấn" được kỳ vọng có tác động dương đến "thu nhập" — nếu hệ số ra âm, cần xem lại mô hình hoặc dữ liệu.
- Không bị đa cộng tuyến nghiêm trọng (VIF < 10, tốt nhất < 5).
- Không có phương sai sai số thay đổi hoặc tự tương quan chưa được xử lý — nếu có, cần dùng các phương pháp ước lượng phù hợp (robust standard errors, FGLS, GLS…).
Nói cách khác, "đẹp" không có nghĩa là mọi biến đều phải có p<5%, mà là kết quả phản ánh đúng bản chất dữ liệu và được ước lượng bằng phương pháp phù hợp.
2. Vì sao kết quả hồi quy bị "xấu"? 4 nhóm nguyên nhân thường gặp
Nguyên nhân 1: Mô hình chưa đúng dạng hàm
Đây là nguyên nhân phổ biến nhất nhưng lại ít được để ý. Các lỗi thường gặp:
- Thiếu biến độc lập quan trọng (omitted variable bias), khiến mô hình không giải thích được nhiều biến động của biến phụ thuộc.
- Sai dạng hàm: dùng dạng tuyến tính trong khi mối quan hệ thực tế là phi tuyến (cần lấy log, bình phương, hoặc thêm biến tương tác).
- Đưa vào biến không liên quan về mặt lý thuyết, làm nhiễu mô hình.
Nguyên nhân 2: Đa cộng tuyến giữa các biến độc lập
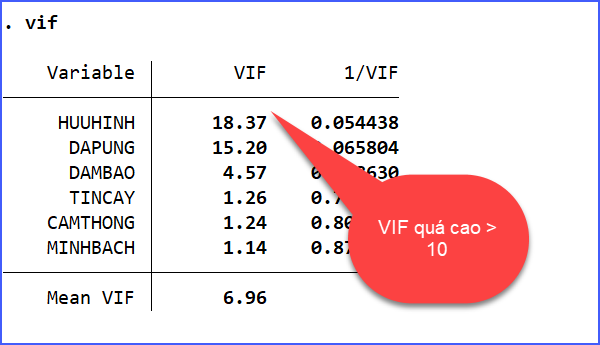
Khi hai hay nhiều biến độc lập có tương quan cao với nhau, mô hình khó tách bạch được tác động riêng của từng biến, dẫn đến hệ số không ổn định, sai số chuẩn bị phóng đại, và p-value không có ý nghĩa dù về lý thuyết biến đó quan trọng.

Nguyên nhân 3: Cỡ mẫu nhỏ hoặc dữ liệu không đại diện
Cỡ mẫu quá nhỏ so với số biến độc lập sẽ làm giảm sức mạnh thống kê (statistical power), khiến ngay cả những tác động thực sự tồn tại cũng khó đạt được ý nghĩa thống kê ở mức p<5%.
Nguyên nhân 4: Phương sai sai số thay đổi và tự tương quan chưa xử lý
Với dữ liệu chéo, phương sai sai số thay đổi (heteroskedasticity) là hiện tượng rất phổ biến. Với dữ liệu bảng và chuỗi thời gian, tự tương quan (autocorrelation) cũng thường xảy ra. Nếu không phát hiện và xử lý, sai số chuẩn bị ước lượng sai, kéo theo p-value không đáng tin cậy.
3. Cách chẩn đoán trong Stata
Trước khi tìm cách "sửa" kết quả, cần chẩn đoán chính xác vấn đề đang gặp phải bằng các lệnh sau (sau khi chạy reg hoặc xtreg):
- Kiểm tra đa cộng tuyến: vif
- Kiểm tra phương sai sai số thay đổi: estat hettest hoặc lệnh kiểm định White/Breusch-Pagan
- Kiểm tra tự tương quan với dữ liệu bảng: xtserial
- Đọc R², R² hiệu chỉnh và p-value ngay trong bảng kết quả sau reg/xtreg
(Bạn có thể xem chi tiết cách thực hiện từng kiểm định này trong các bài viết chuyên sâu khác trên trang.)
4. Cách khắc phục đúng phương pháp
- Loại biến gây đa cộng tuyến dựa trên cơ sở lý thuyết, không phải chọn ngẫu nhiên biến nào cho hệ số đẹp hơn.
- Đổi dạng hàm (lấy log, thêm biến bậc hai) khi có căn cứ lý thuyết cho thấy mối quan hệ phi tuyến, không phải để "làm đẹp" R².
- Sử dụng robust standard errors khi phát hiện phương sai sai số thay đổi, thay vì bỏ qua vấn đề.
- Dùng FGLS/GLS khi có cả phương sai thay đổi và tự tương quan trong dữ liệu bảng.
- Xem xét lại cỡ mẫu và cách thu thập dữ liệu nếu nghi ngờ mẫu không đại diện.
Trong trường hợp vẫn chưa ra được số liệu có ý nghĩa, hay liên hệ dịch vụ xử lý số liệu của ThS Khánh 0903396688 và team để được xử lý triệt để bộ số liệu ra đẹp nhé.

